5. 分類
第 5 回では、機械学習における基本的な分類(Classification) モデルとして、ロジスティック回帰とk-近傍法を学びます。あわせて、分類モデルを評価するための指標(正解率、混同行列、適合率、再現率、F1 スコア)についても扱います。
5.1 分類問題の基礎
5.1.1 2 値分類と多値分類
分類問題は大きく以下の 2 つに分けることができます。
graph TB
    A[分類問題] --> B[2値分類<br/>Binary Classification]
    A --> C[多値分類<br/>Multi-class Classification]

    B --> B1[2つのクラスに分類<br/>例: スパム判定 Yes/No<br/>病気の有無 有/無]
    C --> C1[3つ以上のクラスに分類<br/>例: アヤメの種類 3種<br/>手書き数字 0-9]

    style A fill:#e6ccff
    style B fill:#ccffcc
    style C fill:#ffffcc
2 値分類(Binary Classification):
- 正解ラベルが 2 つ(Yes/No、True/False、0/1 など)
- 例:メールがスパムかどうか、病気の有無
多値分類(Multi-class Classification):
- 正解ラベルが 3 つ以上
- 例:アヤメの種類(3 種)、手書き数字(0-9 の 10 種類)
5.2 ロジスティック回帰
5.2.1 ロジスティック回帰とは
ロジスティック回帰(Logistic Regression) は、名前に「回帰」とついていますが、分類 のためのアルゴリズムです。
線形回帰では \(y = ax + b\) という式で数値を予測しましたが、ロジスティック回帰では シグモイド関数 を使って、0 から 1 の間の確率を出力します。
graph LR
    A[入力<br/>x] --> B[線形結合<br/>z = w·x + b]
    B --> C[シグモイド関数<br/>σz = 1/1+e⁻ᶻ]
    C --> D[確率<br/>0 ≤ P ≤ 1]
    D --> E[分類<br/>P ≥ 0.5 → クラス1<br/>P < 0.5 → クラス0]

    style A fill:#e6f3ff
    style B fill:#fff4cc
    style C fill:#ffcccc
    style D fill:#ffffcc
    style E fill:#ccffcc
シグモイド関数
シグモイド関数は、任意の実数を 0 から 1 の間の値に変換する関数です。
- 入力が大きい正の数 → 1 に近づく
- 入力が大きい負の数 → 0 に近づく
- 入力が 0 → ちょうど 0.5
この性質により、確率を表現するのに適しています。
5.2.2 ロジスティック回帰の実装
scikit-learn でロジスティック回帰を実装するには、sklearn.linear_model.LogisticRegression() クラスを使用します。
import pandas as pd
import numpy as np
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
import seaborn as sns

# tipsデータセットの読み込み
tips = sns.load_dataset('tips')

# データの確認
print(tips.head())

# 特徴量とラベルの分離(チップから時間帯を予測)
X = tips[['tip']]
y = tips['time'].values # Dinne or Lunch

# データ分割
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# ロジスティック回帰モデルの学習
model = LogisticRegression()
model.fit(X_train, y_train)

# 予測
y_pred = model.predict(X_test)

# 精度の計算
accuracy = accuracy_score(y_test, y_pred)
print(f"\n精度: {accuracy:.2%}")
   total_bill   tip     sex smoker  day    time  size
0       16.99  1.01  Female     No  Sun  Dinner     2
1       10.34  1.66    Male     No  Sun  Dinner     3
2       21.01  3.50    Male     No  Sun  Dinner     3
3       23.68  3.31    Male     No  Sun  Dinner     2
4       24.59  3.61  Female     No  Sun  Dinner     4

精度: 69.39%
5.2.3 分類モデルの評価指標
分類問題では、回帰問題とは異なる評価指標を使います。
graph LR
    A[分類モデルの評価指標] --> B[正解率<br/>Accuracy]
    A --> C[適合率<br/>Precision]
    A --> D[再現率<br/>Recall]
    A --> E[F1スコア<br/>F1-Score]
    A --> F[混同行列<br/>Confusion Matrix]
    A --> G[ROC曲線・AUC<br/>ROC Curve / AUC]

    B --> B1[正しく分類できた割合<br/>最も基本的な指標]
    C --> C1[Positiveと予測したうち<br/>実際にPositiveだった割合]
    D --> D1[実際のPositiveのうち<br/>Positiveと予測できた割合]
    E --> E1[適合率と再現率の<br/>調和平均]
    F --> F1[予測と実際の結果を<br/>表で表現]
    G --> G1[閾値を変えた性能を可視化<br/>AUCで総合評価]

    style A fill:#e6ccff
    style B fill:#ccffcc
    style C fill:#ffffcc
    style D fill:#ffcccc
    style E fill:#e6f3ff
    style F fill:#cceeff
style G fill:#ffe0cc正解率(Accuracy)
正解率 は、全体のうち正しく分類できた割合です。
scikit-learn では sklearn.metrics.accuracy_score() で計算します。
from sklearn.metrics import accuracy_score

accuracy = accuracy_score(y_test, y_pred)
print(f"正解率: {accuracy:.2%}")
混同行列(Confusion Matrix)
混同行列 は、予測結果と実際の結果を表形式で表現したものです。N クラス分類なら N×N の行列 になります(2 値分類なら 2×2、アヤメのような 3 クラス分類なら 3×3)。行が「実際のクラス」、列が「予測したクラス」を表すのが一般的です。
2 値分類の場合:
| 予測:0(Negative) | 予測:1(Positive) | |
|---|---|---|
| 実際:0(Negative) | TN(真陰性) | FP(偽陽性) |
| 実際:1(Positive) | FN(偽陰性) | TP(真陽性) |
- TP(True Positive): 正しく Positive と予測
- TN(True Negative): 正しく Negative と予測
- FP(False Positive): 誤って Positive と予測(第一種過誤)
- FN(False Negative): 誤って Negative と予測(第二種過誤)
多値分類の場合:対角成分が「正しく分類できた数」、それ以外が「どのクラスをどのクラスと取り違えたか」を表します。例えば 3 クラス分類で cm[1][2] の値は「実際はクラス 1 なのにクラス 2 と予測した数」を意味します。
TP/FP の概念は多値分類でも使える
多値分類でも、特定の 1 クラスに着目 すれば「そのクラスを Positive、それ以外を Negative」と見なすことで TP/FP/FN/TN を定義できます(One-vs-Rest)。classification_report のクラスごとの precision・recall はこの考え方で計算されています。
scikit-learn では sklearn.metrics.confusion_matrix() で計算します。
from sklearn.metrics import confusion_matrix
import seaborn as sns

# 混同行列
cm = confusion_matrix(y_test, y_pred)
print("混同行列:")
print(cm)
モデルの性能について
上記の混同行列を見ると、すべてのデータがDinner(0列目)と予測されており、Lunch(1列目)と予測されたものが1つもありません(すべて0)。これは、モデルが「常にDinnerと予測する」という単純な戦略を学習してしまった状態です。
なぜこのような結果になったのか?
- 特徴量が不足:
tip(チップ)だけでは時間帯を予測するのに十分な情報がない - データの偏り:Dinnerのデータ数がLunchより多い(176件 vs 61件)
改善するにはどうすればよいか?
- 特徴量を増やす:
total_bill(合計金額)、size(人数)なども使う - カテゴリ変数を活用:
sex(性別)、smoker(喫煙者)、day(曜日)を数値化するpd.get_dummies()を使ってダミー変数化(One-Hot Encoding)
例:ダミー変数化
# カテゴリ変数をダミー変数化
X = pd.get_dummies(tips[['total_bill', 'tip', 'sex', 'smoker', 'day']], drop_first=True)
このように、特徴量エンジニアリング(特徴量の選択・加工)は機械学習で非常に重要です。
適合率(Precision)
適合率(Precision) は、Positive と予測したうち、実際に Positive だった割合です。偽陽性(誤って Positive と予測すること)を減らしたいときに重視します。
scikit-learn では sklearn.metrics.precision_score() で計算します。
from sklearn.metrics import precision_score

# pos_label で「Positive」とみなすクラスを指定(文字列ラベルの場合は必須)
precision = precision_score(y_test, y_pred, pos_label='Lunch')
print(f"適合率(Lunch): {precision:.2%}")
再現率(Recall)
再現率(Recall) は、実際の Positive のうち、Positive と予測できた割合です。偽陰性(実際は Positive なのに Negative と予測してしまうこと)を減らしたいときに重視します。
scikit-learn では sklearn.metrics.recall_score() で計算します。
from sklearn.metrics import recall_score

recall = recall_score(y_test, y_pred, pos_label='Lunch')
print(f"再現率(Lunch): {recall:.2%}")
適合率と再現率のトレードオフ
適合率を重視する場合(偽陽性を減らしたい)
- スパムメール判定(普通のメールをスパムと判定するのを避けたい)
- 広告配信(興味のない人に広告を出すのを避けたい)
再現率を重視する場合(偽陰性を減らしたい)
- 病気の診断(病気を見逃さないようにしたい)
- 不正取引の検出(不正を見逃さないようにしたい)
通常、適合率と再現率はトレードオフの関係にあります。
F1 スコア
F1 スコア は、適合率と再現率の調和平均です。適合率と再現率のバランスを取った指標で、両方を重視したい場合に使います。
scikit-learn では sklearn.metrics.f1_score() で計算します。
from sklearn.metrics import f1_score

f1 = f1_score(y_test, y_pred, pos_label='Lunch')
print(f"F1スコア(Lunch): {f1:.2%}")
ROC 曲線と AUC
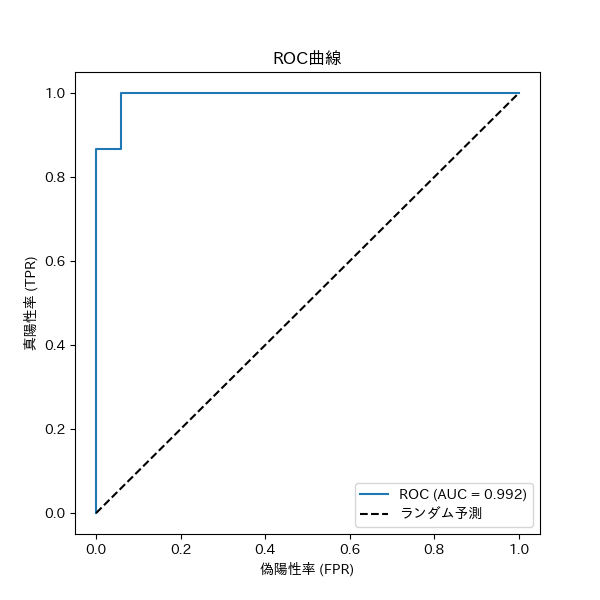
ロジスティック回帰は確率を出力するため、「どの確率以上を Positive とみなすか」という 閾値(threshold) を変えることで、適合率と再現率のバランスを調整できます。閾値を変えながらモデルの性能を可視化したものが ROC 曲線(Receiver Operating Characteristic Curve) です。
- 横軸:偽陽性率(FPR) = FP / (FP + TN)
- 縦軸:真陽性率(TPR) = Recall = TP / (TP + FN)
graph LR
    A[ROC曲線の見方] --> B[左上に近いほど良い<br/>FPR小・TPR大]
    A --> C[対角線=ランダム予測<br/>AUC=0.5]
    A --> D[完璧なモデル<br/>AUC=1.0]

    style A fill:#e6ccff
    style B fill:#ccffcc
    style C fill:#ffffcc
    style D fill:#cceeff
AUC(Area Under the Curve) は ROC 曲線の下側の面積で、0.5(ランダム)〜 1.0(完璧)の値をとります。閾値に依存しない単一の指標としてモデル比較に便利です。
5.2.2 の例ではモデルが「常に Dinner」と予測していたため、評価指標を実感しにくいです。ここでは特徴量を増やしたうえで ROC 曲線と AUC を計算してみます。scikit-learn では sklearn.metrics.roc_curve() と sklearn.metrics.roc_auc_score() を使います。
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import roc_curve, roc_auc_score
import seaborn as sns

# データ準備(特徴量を増やしてダミー変数化)
tips = sns.load_dataset('tips')
X = pd.get_dummies(
    tips[['total_bill', 'tip', 'sex', 'smoker', 'day', 'size']],
    drop_first=True
)
y = (tips['time'] == 'Lunch').astype(int)  # Lunch=1, Dinner=0

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 学習
model = LogisticRegression(max_iter=1000)
model.fit(X_train, y_train)

# Positiveクラス(Lunch=1)の予測確率を取得
y_proba = model.predict_proba(X_test)[:, 1]

# ROC曲線とAUC
fpr, tpr, thresholds = roc_curve(y_test, y_proba)
auc = roc_auc_score(y_test, y_proba)
print(f"AUC: {auc:.3f}")

# 可視化
plt.figure(figsize=(6, 6))
plt.plot(fpr, tpr, label=f'ROC (AUC = {auc:.3f})')
plt.plot([0, 1], [0, 1], 'k--', label='ランダム予測')
plt.xlabel('偽陽性率 (FPR)')
plt.ylabel('真陽性率 (TPR)')
plt.title('ROC曲線')
plt.legend()
plt.show()
predict と predict_proba の違い
model.predict(X):予測クラス(例:'Lunch'or'Dinner')を返すmodel.predict_proba(X):各クラスに属する確率を返す(行ごとに合計1.0)
閾値を変えた評価や ROC/AUC の計算には predict_proba が必要です。
5.2.4 多値分類への拡張
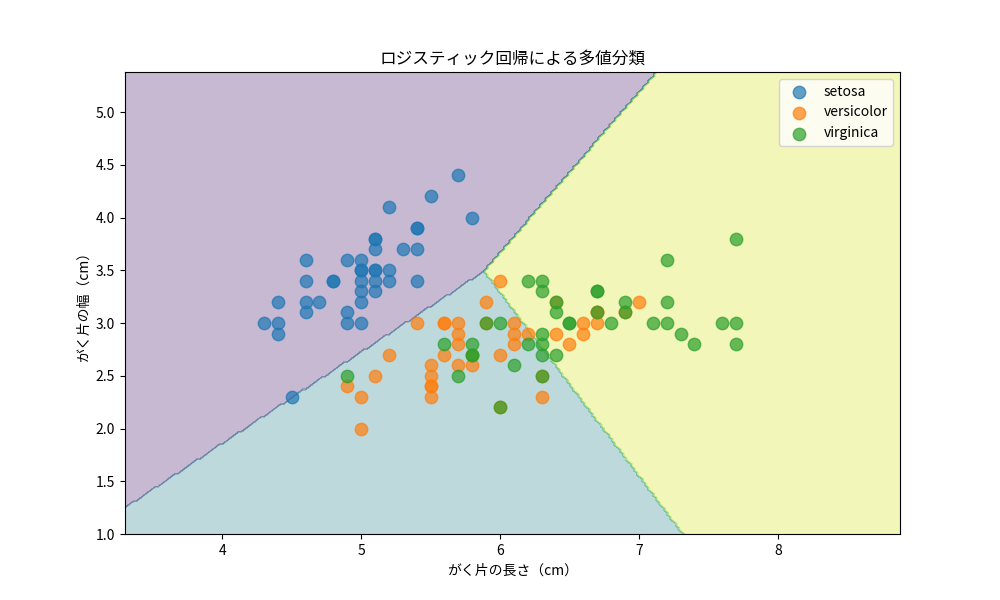
ロジスティック回帰は、多値分類にも対応できます。scikit-learn の LogisticRegression はデフォルトで多値分類をサポートしています。クラスごとの精度・適合率・再現率・F1 スコアをまとめて確認するには sklearn.metrics.classification_report() が便利です。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score, classification_report
import seaborn as sns

# アヤメデータセットの読み込み
iris = sns.load_dataset('iris')

# 特徴量とラベルの分離
X = iris[['sepal_length', 'sepal_width']].values
y = iris['species'].values

# データ分割
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# モデルの学習
model = LogisticRegression(max_iter=200)
model.fit(X_train, y_train)

# 予測
y_pred = model.predict(X_test)

# 精度の計算
accuracy = accuracy_score(y_test, y_pred)
print(f"精度: {accuracy:.2%}")

# 詳細なレポート
print("\n分類レポート:")
print(classification_report(y_test, y_pred))
精度: 90.00%

分類レポート:
              precision    recall  f1-score   support

      setosa       1.00      1.00      1.00        10
  versicolor       0.88      0.78      0.82         9
   virginica       0.83      0.91      0.87        11

    accuracy                           0.90        30
   macro avg       0.90      0.90      0.90        30
weighted avg       0.90      0.90      0.90        30
分類結果の可視化例
5.3 k-近傍法
5.3.1 k-近傍法とは
k-近傍法(k-Nearest Neighbors, k-NN) は、新しいデータを分類するときに「最も近い k 個の訓練データ」を見て、その多数決でクラスを決める非常にシンプルなアルゴリズムです。
graph LR
    A[新しいデータ] --> B[訓練データとの<br/>距離を計算]
    B --> C[近い順に k 個選ぶ]
    C --> D[多数決でクラス決定]

    style A fill:#e6f3ff
    style B fill:#fff4cc
    style C fill:#ffcccc
    style D fill:#ccffcc
k-NN の特徴
- 学習がない(怠惰学習):訓練データをそのまま記憶するだけで、予測時に距離計算する
- 非線形な境界:複雑な決定境界を表現できる
- 解釈しやすい:「近いデータと同じクラス」という直感的なルール
- 距離に敏感:特徴量のスケールが揃っていないとうまく動かない(標準化が必須)
- 予測が遅い:データ数が多いほど予測時の計算量が増える
ロジスティック回帰との違い
| ロジスティック回帰 | k-近傍法 | |
|---|---|---|
| 学習方法 | パラメータを最適化 | 訓練データを記憶するだけ |
| 決定境界 | 線形 | 非線形(局所的) |
| 予測速度 | 速い | 遅い(データ数に比例) |
| データのスケール | 影響少なめ | 標準化が必須 |
5.3.2 k-近傍法の実装
scikit-learn で k-NN を実装するには、sklearn.neighbors.KNeighborsClassifier() クラスを使用します。距離ベースの手法なので、特徴量の標準化 をセットで行うのが基本です(標準化には sklearn.preprocessing.StandardScaler() を使います)。
import numpy as np
from sklearn.neighbors import KNeighborsClassifier
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score, classification_report
import seaborn as sns

# アヤメデータセットの読み込み
iris = sns.load_dataset('iris')
X = iris[['sepal_length', 'sepal_width', 'petal_length', 'petal_width']].values
y = iris['species'].values

# データ分割
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 標準化(訓練データで fit、テストには transform のみ)
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# k-NN モデルの学習(k=5)
model = KNeighborsClassifier(n_neighbors=5)
model.fit(X_train_scaled, y_train)

# 予測と評価
y_pred = model.predict(X_test_scaled)
print(f"精度: {accuracy_score(y_test, y_pred):.2%}")
print("\n分類レポート:")
print(classification_report(y_test, y_pred))
精度: 100.00%

分類レポート:
              precision    recall  f1-score   support

      setosa       1.00      1.00      1.00        10
  versicolor       1.00      1.00      1.00         9
   virginica       1.00      1.00      1.00        11

    accuracy                           1.00        30
   macro avg       1.00      1.00      1.00        30
weighted avg       1.00      1.00      1.00        30
標準化を忘れるとどうなるか
例えば「年齢(0〜100)」と「年収(0〜10,000,000)」を特徴量に使うと、年収のスケールが大きすぎて距離計算がほぼ年収だけで決まってしまいます。
StandardScaler で各特徴量を「平均0・標準偏差1」に揃えることで、全ての特徴量が公平に距離に寄与するようになります。
5.3.3 ハイパーパラメータ k の選び方
k-NN の最も重要なハイパーパラメータが n_neighbors(= k) です。
- k が小さい(例:k = 1):1 つの近傍だけで決めるため、ノイズに敏感で 過学習しやすい
- k が大きい:広い範囲を見るため境界が滑らかになるが、大きすぎると 未学習 になる
import matplotlib.pyplot as plt
from sklearn.neighbors import KNeighborsClassifier
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
import seaborn as sns

iris = sns.load_dataset('iris')
X = iris[['sepal_length', 'sepal_width', 'petal_length', 'petal_width']].values
y = iris['species'].values

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# k を変えて精度を比較
ks = range(1, 21)
train_acc, test_acc = [], []
for k in ks:
    model = KNeighborsClassifier(n_neighbors=k)
    model.fit(X_train_scaled, y_train)
    train_acc.append(model.score(X_train_scaled, y_train))
    test_acc.append(model.score(X_test_scaled, y_test))

plt.figure(figsize=(8, 5))
plt.plot(ks, train_acc, marker='o', label='訓練精度')
plt.plot(ks, test_acc, marker='s', label='テスト精度')
plt.xlabel('k (n_neighbors)')
plt.ylabel('精度')
plt.title('k-NN: k と精度の関係')
plt.legend()
plt.grid(True, alpha=0.3)
plt.show()
適切な k の選び方
- 目安:\(k = \sqrt{\rm (訓練データ数)}\) 付近から試す
- 奇数を選ぶ:2 値分類の場合、多数決で同票になるのを避けるため
- 交差検証:
GridSearchCVなどで複数の k を試して最も良いものを選ぶ
5.4 演習問題
演習 5-1: tips データセットでロジスティック回帰
演習 5-1(初級)
tips データセットを使って、食事の情報から時間帯(time:Lunch / Dinner)を予測するロジスティック回帰を実装してください。
タスク
- tips データセットを読み込み、先頭 5 行を表示する
- 特徴量
X = tips[['total_bill', 'tip', 'size']]、ラベルy = tips['time']を準備する - データを「訓練 80%、テスト 20%」(
random_state=42)に分割する - ロジスティック回帰モデル
LogisticRegression(max_iter=1000)を学習する - テストデータで予測し、正解率(accuracy)を計算して表示する
- 学習された各特徴量の「係数」と「切片」を表示し、どの特徴量が予測に効いているか確認する
import seaborn as sns
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

# 1. データの読み込みと先頭 5 行の表示

# 2. 特徴量 X とラベル y の設定

# 3. 訓練・テストに分割(8:2, random_state=42)

# 4. モデルの作成と学習

# 5. テストデータで予測し、正解率を表示

# 6. 係数と切片の表示
演習 5-2: iris データセットで k-近傍法
演習 5-2(初級)
iris データセットを使って、4 つの数値特徴量からアヤメの種類(species)を分類する k-近傍法を実装してください。k-NN は距離ベースの手法なので、特徴量の標準化をセットで行います。
タスク
- iris データセットを読み込み、特徴量
X(sepal_length,sepal_width,petal_length,petal_widthの 4 列)とラベルy = iris['species']を準備する - データを「訓練 80%、テスト 20%」(
random_state=42)に分割する StandardScalerで特徴量を標準化する(訓練データでfit_transform、テストデータはtransformのみ)- k-NN モデル
KNeighborsClassifier(n_neighbors=5)を学習する - テストデータで予測し、正解率を表示する
classification_reportでクラスごとの適合率・再現率・F1 スコアを表示する
import seaborn as sns
from sklearn.neighbors import KNeighborsClassifier
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score, classification_report

# 1. データの読み込みと特徴量 X・ラベル y の設定

# 2. 訓練・テストに分割(8:2, random_state=42)

# 3. StandardScaler で標準化

# 4. k-NN モデル(n_neighbors=5)の学習

# 5. テストデータで予測し、正解率を表示

# 6. classification_report の表示
演習 5-3: 評価指標の計算と読み取り
演習 5-3(中級)
演習 5-1 と同じロジスティック回帰モデル(tips, total_bill・tip・size → time)について、混同行列・適合率・再現率・F1 スコアを計算し、結果を読み取って考察してください。
タスク
- 演習 5-1 と同じ設定でモデルを学習し、テストデータを予測する
confusion_matrixをlabels=['Dinner', 'Lunch']指定で計算し、配列を表示するseabornのヒートマップで混同行列を可視化するLunchを Positive(pos_label='Lunch')として適合率・再現率・F1 スコアを計算・表示するclassification_reportでクラスごとの指標を表示する- 出力結果を見て、「どちらのクラスを間違えやすいか・なぜそうなるのか」をコメントで考察する
import seaborn as sns
import matplotlib.pyplot as plt
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import (confusion_matrix, precision_score,
                             recall_score, f1_score, classification_report)

# 1. 演習 5-1 と同じモデルを学習し、テストデータを予測

# 2. confusion_matrix の計算と表示(labels=['Dinner', 'Lunch'])

# 3. ヒートマップで混同行列を可視化

# 4. Lunch を Positive とした適合率・再現率・F1 スコア

# 5. classification_report の表示

# 6. 考察(どのクラスを間違えやすいか・なぜか)をコメントで記述
演習 5-4: ロジスティック回帰と k-近傍法の比較
演習 5-4(上級)
iris データセットを sepal_length と sepal_width の 2 特徴量だけに絞り、ロジスティック回帰と k-近傍法の性能を比較してください。さらに k-NN のハイパーパラメータ n_neighbors(k)を変えて、最も精度の良い k を探します。
タスク
- iris から特徴量
X = iris[['sepal_length', 'sepal_width']]、ラベルy = iris['species']を準備する - データを「訓練 80%、テスト 20%」(
random_state=42)に分割する - k-NN 用に
StandardScalerで標準化する - ロジスティック回帰
LogisticRegression(max_iter=200)を学習し、正解率とclassification_reportを表示する - k-NN
KNeighborsClassifier(n_neighbors=5)(標準化データ)を学習し、正解率とclassification_reportを表示する n_neighborsを 1〜20 まで変えてテスト正解率を計算し、最も良い k を表示する。さらに k とテスト正解率の関係を折れ線グラフで可視化する- 2 つのモデルの結果を比較し、どちらが良いか・なぜそうなるかをコメントで考察する
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.linear_model import LogisticRegression
from sklearn.neighbors import KNeighborsClassifier
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score, classification_report

# 1. 特徴量 X(sepal の 2 列)とラベル y の設定

# 2. 訓練・テストに分割(8:2, random_state=42)

# 3. StandardScaler で標準化

# 4. ロジスティック回帰の学習・評価

# 5. k-NN(n_neighbors=5)の学習・評価

# 6. k を 1〜20 で変えて最良の k を探索し、グラフで可視化

# 7. 2 モデルの比較・考察をコメントで記述
5.5 まとめ
本章では、分類問題の基礎、ロジスティック回帰、k-近傍法について学びました。
第 5 回のまとめ
分類問題の基礎
- 回帰は数値予測、分類はカテゴリ予測
- 2値分類(2クラス)と多値分類(3クラス以上)
- 実務での応用範囲が広い
ロジスティック回帰
- シグモイド関数で確率を出力
- 線形な決定境界
- シンプルで解釈しやすい
- 多値分類にも対応可能
k-近傍法(k-NN)
- 近い k 個のデータの多数決でクラスを決定
- 学習はせずに訓練データを記憶するだけ(怠惰学習)
- 非線形な決定境界を表現できる
- 距離ベースなので 標準化が必須
n_neighbors(k)の選び方が重要
評価指標
- 正解率(Accuracy):基本的な指標
- 混同行列(Confusion Matrix):予測の詳細を把握
- 適合率(Precision):偽陽性を重視
- 再現率(Recall):偽陰性を重視
- F1スコア:適合率と再現率のバランス
- ROC 曲線 / AUC:閾値に依存しない総合的な性能評価
次章では、より複雑な分類モデルとして決定木やランダムフォレストなどの木構造とアンサンブル学習を扱います。