9. 画像データを用いた機械学習
第 9 回では、前回学んだ古典的な特徴抽出手法を用いた画像分類の実践について学びます。また、最後に現代の画像認識の中心的手法である CNN(Convolutional Neural Network)についても簡単に紹介します。
9.1 画像分類とは
9.1.1 画像分類の概要
画像分類(Image Classification) は、画像を見て、それがどのカテゴリに属するかを判定するタスクです。
graph LR
    A[入力画像] --> B[特徴抽出]
    B --> C[機械学習<br/>モデル]
    C --> D[クラス予測<br/>猫/犬/鳥など]

    style A fill:#e6f3ff,stroke:#66b3ff,stroke-width:3px
    style B fill:#fff4cc,stroke:#ffcc00,stroke-width:3px
    style C fill:#ccffcc,stroke:#66cc66,stroke-width:3px
    style D fill:#ffcccc,stroke:#ff6666,stroke-width:3px
画像分類の応用例
- 医療画像診断(X 線画像から病変を検出)
- 製品の品質検査(良品/不良品の判定)
- 文字認識(手書き文字の識別)
- 物体認識(写真に写っている物体の識別)
9.1.2 画像分類のワークフロー
画像分類は以下の手順で行います。
graph TB
    A[1. データ準備<br/>画像とラベル] --> B[2. 特徴抽出<br/>HOGなど]
    B --> C[3. データ分割<br/>訓練/テスト]
    C --> D[4. モデル学習<br/>分類器の訓練]
    D --> E[5. モデル評価<br/>精度の測定]
    E --> F{精度は<br/>十分?}
    F -->|No| G[6. 改善<br/>パラメータ調整]
    G --> B
    F -->|Yes| H[完成]

    style A fill:#e6f3ff,stroke:#66b3ff,stroke-width:2px
    style B fill:#fff4cc,stroke:#ffcc00,stroke-width:2px
    style C fill:#ccffcc,stroke:#66cc66,stroke-width:2px
    style D fill:#ffffcc,stroke:#ffcc00,stroke-width:2px
    style E fill:#ffcccc,stroke:#ff6666,stroke-width:2px
    style F fill:#e6ccff,stroke:#9966ff,stroke-width:2px
    style G fill:#ffe6cc,stroke:#ff9933,stroke-width:2px
    style H fill:#ccffcc,stroke:#66cc66,stroke-width:3px
9.1.3 MNIST データセット
本章では、機械学習の分野で最も有名なベンチマークデータセットの一つである MNIST(Mixed National Institute of Standards and Technology) を使用します。

MNIST データセットの特徴
| 項目 | 内容 |
|---|---|
| 内容 | 0〜9 の手書き数字画像 |
| 画像サイズ | 28×28 ピクセル(グレースケール) |
| 訓練データ | 60,000 枚 |
| テストデータ | 10,000 枚 |
| クラス数 | 10(数字 0〜9) |
MNIST は 1998 年に Yann LeCun らによって公開され、以下の理由から機械学習の入門に広く使われています。
- シンプルな構造: 28×28 の小さな画像で、計算コストが低い
- 明確なタスク: 10 クラスの分類問題で、評価が容易
- 研究実績: 多くの手法のベンチマークとして使用されている
本章で使用するサブセット
オリジナルの MNIST は 70,000 枚の画像を含みますが、本講義では学習時間を短縮するため、500〜2000 枚程度のサブセットを使用します。
9.2 生の画素値を用いた画像分類
9.2.1 データセットの準備
以下では、MNIST データセットのサブセット(手書き数字)を使って、画像分類の基本を学んでいきます。サブセットデータをダウンロードし、ローカルまたはクラウドのワークスペースに配置(アップロード)したうえで、以下のコードを実行して中身を確認してみましょう。
import numpy as np
import matplotlib.pyplot as plt

# MNISTサブセットの読み込み
data = np.load('mnist_500_raw.npz')
X = data['X']  # (500, 784)  500枚の画像(各画像:28×28=784ピクセル)
y = data['y']  # (500,)  ラベル(0-9)

print(f"画像データの形状: {X.shape}")
print(f"画像の枚数: {len(X)}")
print(f"各画像のサイズ: 28×28 ピクセル")
print(f"クラス数: {len(np.unique(y))}")
print(f"クラス: {np.unique(y)}")
print(f"ラベル分布: {np.bincount(y)}")

# 画像を28×28に reshape
X_images = X.reshape(-1, 28, 28)

# サンプル画像の表示
fig, axes = plt.subplots(5, 5, figsize=(8, 8))
for i in range(25):
    ax = axes[i // 5, i % 5]
    ax.imshow(X_images[i], cmap='gray')
    ax.set_title(f'ラベル: {y[i]}')
    ax.axis('off')

plt.tight_layout()
plt.show()
画像データの形状: (500, 784)
画像の枚数: 500
各画像のサイズ: 28×28 ピクセル
クラス数: 10
クラス: [0 1 2 3 4 5 6 7 8 9]
ラベル分布: [50 50 50 50 50 50 50 50 50 50]
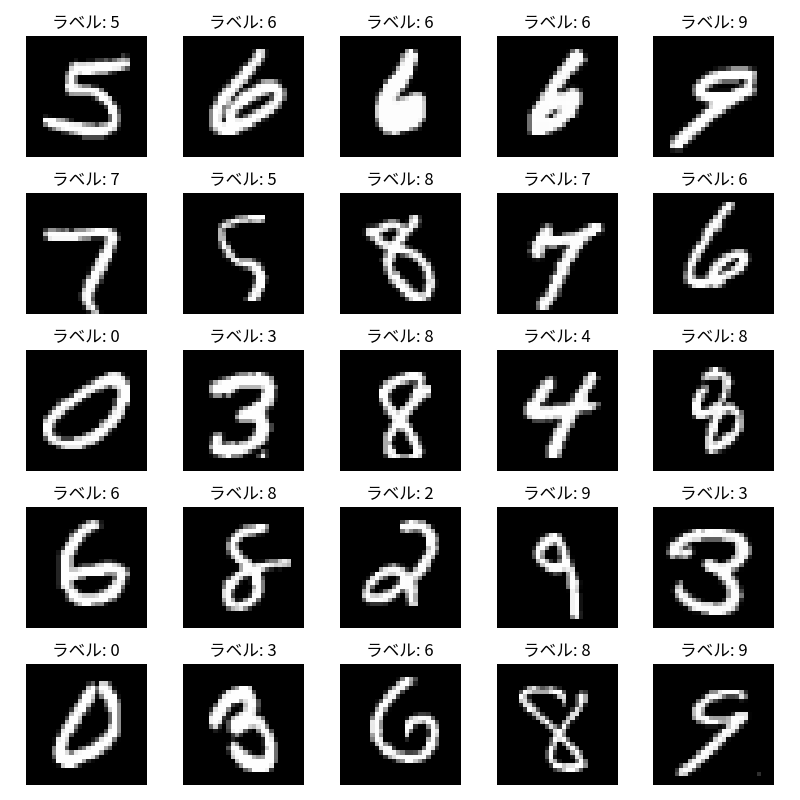
MNIST サブセット
- サイズ: 28×28 ピクセルのグレースケール画像
- 枚数: 500 枚(各クラス50枚ずつ)
- クラス: 0〜9 の手書き数字(10クラス)
- 用途: 本講義における画像分類の練習
- データセット:
MNIST 全体(70,000 枚)を使う場合
sklearn.datasets.fetch_openml() で MNIST 全体を読み込めます。初回はネットワークから 12 MB ほどダウンロードしますが、2 回目以降はローカルにキャッシュされて高速に読み込めます。
from sklearn.datasets import fetch_openml
import numpy as np

mnist = fetch_openml('mnist_784', version=1, as_frame=False, parser='auto')
X = mnist.data.astype(np.uint8)    # (70000, 784)
y = mnist.target.astype(np.uint8)  # (70000,)
print(f"画像データの形状: {X.shape}")
print(f"ラベル分布: {np.bincount(y)}")
サブセットと同じ (N, 784) 形式の NumPy 配列が得られるので、以降のコードはそのまま動きます。ただし、サンプル数に比例して学習時間が長くなる点には注意してください。
9.2.2 生の画素値で分類
まずは特徴抽出をせず、生の画素値をそのまま使って 決定木(Decision Tree) で分類してみます。
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix
import matplotlib.pyplot as plt
import seaborn as sns

# データの読み込み
data = np.load('mnist_500_raw.npz')
X = data['X']  # (500, 784) - 生の画素値
y = data['y']

# データ分割
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

print(f"訓練データ: {X_train.shape}")
print(f"テストデータ: {X_test.shape}")

# 決定木
model = DecisionTreeClassifier(random_state=42)
model.fit(X_train, y_train)

# 予測
y_pred = model.predict(X_test)

# 精度評価
accuracy = accuracy_score(y_test, y_pred)
print(f"\nテスト精度: {accuracy:.4f} ({accuracy:.2%})")

print("\n分類レポート:")
print(classification_report(y_test, y_pred))

# 混同行列の可視化
cm = confusion_matrix(y_test, y_pred)

plt.figure(figsize=(8, 6))
sns.heatmap(cm, annot=True, fmt='d', cmap='Blues', cbar_kws={'label': '件数'})
plt.xlabel('予測ラベル')
plt.ylabel('正解ラベル')
plt.title(f'混同行列(精度: {accuracy:.3f})')
plt.tight_layout()
plt.show()
訓練データ: (400, 784)
テストデータ: (100, 784)

テスト精度: 0.6000 (60.00%)

分類レポート:
              precision    recall  f1-score   support

           0       0.86      0.60      0.71        10
           1       0.82      0.90      0.86        10
           2       0.55      0.60      0.57        10
           3       0.50      0.40      0.44        10
           4       0.67      0.60      0.63        10
           5       0.50      0.70      0.58        10
           6       0.60      0.60      0.60        10
           7       0.60      0.90      0.72        10
           8       0.33      0.30      0.32        10
           9       0.67      0.40      0.50        10

    accuracy                           0.60       100
   macro avg       0.61      0.60      0.59       100
weighted avg       0.61      0.60      0.59       100
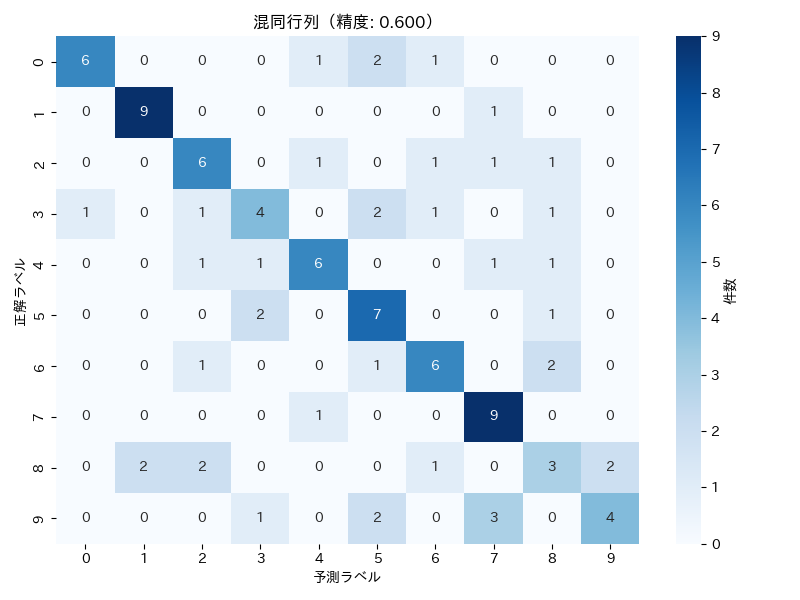
生の画素値 + 決定木の性能
精度は約 60%と、ランダム選択(10%)よりは良いですが、決定木は 1 つの画素値の閾値で分岐するため、784 次元の生の画素値からは「どの 1 画素が決め手か」が決まらず、本質的に限界があります。次節では HOG 特徴量で形状情報を取り出し、演習 9-1 では同じ生画素値をロジスティック回帰で扱うとどう変わるかを確認します。
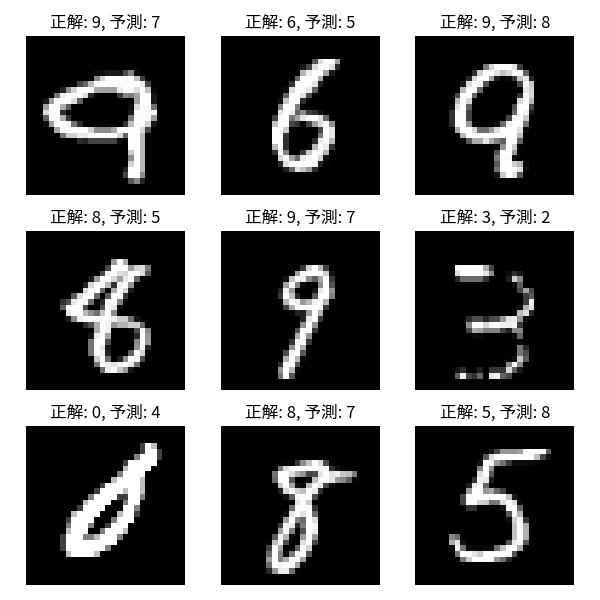
9.2.3 誤分類された画像の確認
モデルがどのような画像を間違えたのかを確認することで、モデルの弱点を理解できます。弱点を理解することで、モデルの改善策(特徴量の工夫、データ拡張など)が見えてきます。
import numpy as np
import matplotlib.pyplot as plt

# 誤分類されたサンプルを抽出
misclassified_indices = np.where(y_test != y_pred)[0]
print(f"誤分類されたサンプル数: {len(misclassified_indices)}")

# 誤分類された画像を表示
if len(misclassified_indices) > 0:
    # 最大9個まで表示
    num_display = min(9, len(misclassified_indices))
    fig, axes = plt.subplots(3, 3, figsize=(9, 9))
    axes = axes.ravel()

    for i in range(num_display):
        idx = misclassified_indices[i]
        # テストデータのインデックスから元の画像を取得
        test_sample_image = X_test[idx].reshape(28, 28)

        axes[i].imshow(test_sample_image, cmap='gray')
        axes[i].set_title(f'正解: {y_test[idx]}, 予測: {y_pred[idx]}')
        axes[i].axis('off')

    # 残りのサブプロットを非表示
    for i in range(num_display, 9):
        axes[i].axis('off')

    plt.tight_layout()
    plt.show()
else:
    print("誤分類されたサンプルはありません")
9.3 HOG 特徴量を用いた画像分類
9.3.1 HOG 特徴量の抽出
生の画素値よりも効果的な特徴表現として、HOG(Histogram of Oriented Gradients)特徴量を使うことができます。HOG はエッジの方向のヒストグラムを取ることで、画像の重要な情報を捉えます。
import numpy as np
from skimage.feature import hog
from skimage import exposure
import matplotlib.pyplot as plt

# データの読み込み
data = np.load('mnist_500_raw.npz')
X = data['X']
y = data['y']

# 画像を28×28に reshape
X_images = X.reshape(-1, 28, 28)

# HOG特徴量の抽出
hog_features = []
for image in X_images:
    fd = hog(
        image,
        orientations=9,
        pixels_per_cell=(4, 4),
        cells_per_block=(2, 2),
        visualize=False)
    hog_features.append(fd)

X_hog = np.array(hog_features)

print(f"HOG特徴量の形状: {X_hog.shape}")
print(f"各画像の特徴量次元: {X_hog.shape[1]}")
print(f"元の画素数: {X.shape[1]}")

# サンプル画像とHOG特徴量の可視化
sample_idx = 0
fd, hog_image = hog(
    X_images[sample_idx],
    orientations=9,
    pixels_per_cell=(7, 7),
    cells_per_block=(2, 2),
    visualize=True)

hog_image_rescaled = exposure.rescale_intensity(hog_image, in_range=(0, 10))

fig, axes = plt.subplots(1, 2, figsize=(7, 4))

axes[0].imshow(X_images[sample_idx], cmap='gray')
axes[0].set_title(f'元画像(ラベル: {y[sample_idx]})')
axes[0].axis('off')

axes[1].imshow(hog_image_rescaled, cmap='gray')
axes[1].set_title('HOG 特徴量')
axes[1].axis('off')

plt.tight_layout()
plt.show()
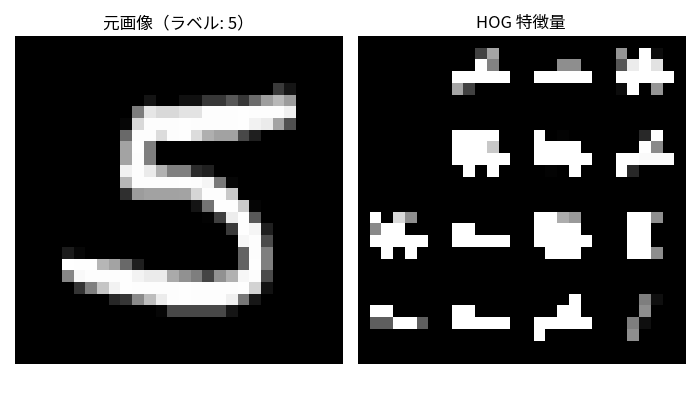
9.3.2 モデルの学習と評価
HOG 特徴量を使って 決定木 で分類モデルを学習するコード例は以下のようになります。9.2 節と同じ決定木を使い、特徴量だけを HOG に置き換えています。
import numpy as np
from skimage.feature import hog
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix
import matplotlib.pyplot as plt
import seaborn as sns

# データの読み込みとHOG特徴量の抽出
data = np.load('mnist_500_raw.npz')
X = data['X']
y = data['y']

X_images = X.reshape(-1, 28, 28)

hog_features = []
for image in X_images:
    fd = hog(
        image, orientations=9,
        pixels_per_cell=(7, 7),
        cells_per_block=(2, 2),
        visualize=False)
    hog_features.append(fd)

X_hog = np.array(hog_features)

# データ分割
X_train, X_test, y_train, y_test = train_test_split(
    X_hog, y, test_size=0.2, random_state=42, stratify=y
)

print(f"訓練データ: {X_train.shape}")
print(f"テストデータ: {X_test.shape}")

# 決定木で学習
model = DecisionTreeClassifier(random_state=42)
model.fit(X_train, y_train)

# 予測
y_pred = model.predict(X_test)

# 精度評価
accuracy = accuracy_score(y_test, y_pred)
print(f"\nテスト精度: {accuracy:.4f} ({accuracy:.2%})")

print("\n分類レポート:")
print(classification_report(y_test, y_pred))

# 混同行列の可視化
cm = confusion_matrix(y_test, y_pred)

plt.figure(figsize=(8, 6))
sns.heatmap(cm, annot=True, fmt='d', cmap='Blues', cbar_kws={'label': '件数'})
plt.xlabel('予測ラベル')
plt.ylabel('正解ラベル')
plt.title(f'混同行列(精度: {accuracy:.3f})')
plt.tight_layout()
plt.show()
訓練データ: (400, 324)
テストデータ: (100, 324)

テスト精度: 0.5600 (56.00%)

分類レポート:
              precision    recall  f1-score   support

           0       0.25      0.20      0.22        10
           1       0.78      0.70      0.74        10
           2       0.45      0.50      0.48        10
           3       0.60      0.60      0.60        10
           4       0.73      0.80      0.76        10
           5       0.55      0.60      0.57        10
           6       0.46      0.60      0.52        10
           7       0.71      0.50      0.59        10
           8       0.50      0.60      0.55        10
           9       0.62      0.50      0.56        10

    accuracy                           0.56       100
   macro avg       0.57      0.56      0.56       100
weighted avg       0.57      0.56      0.56       100
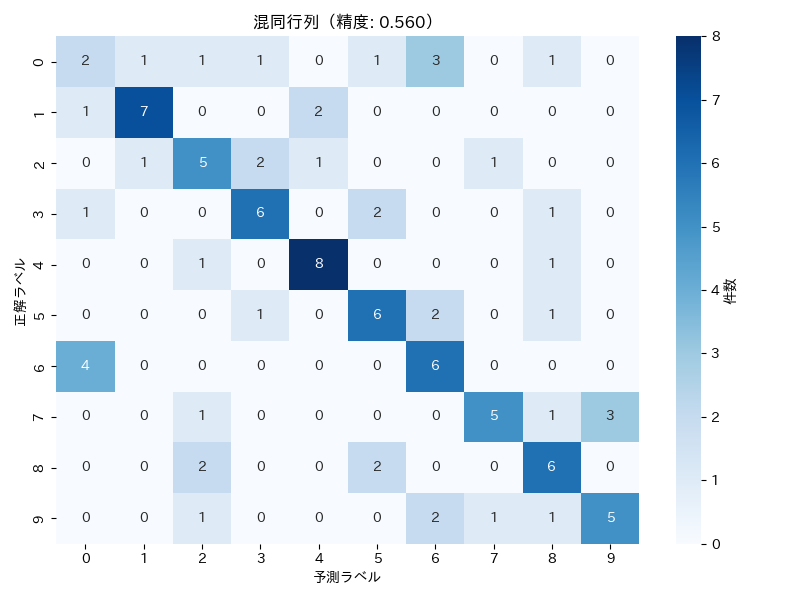
HOG + 決定木の性能
精度は約 56%。9.2 節の「生画素 + 決定木(60%)」とほぼ同じで、HOG にしても伸びません。HOG は 324 次元のベクトルとして勾配方向の分布を滑らかに表現しますが、決定木は 1 次元ずつ閾値で分割するため、その連続的な構造を活かしきれないためです。特徴量を改善してもモデルが合わなければ意味がない、ということを示しています。演習 9-2 で同じ HOG をロジスティック回帰で扱うとどう変わるかを確認します。
9.4 カラー画像の分類:CIFAR-10 と RGB ヒストグラム
ここまでは MNIST(グレースケール)を題材にしてきましたが、第 8 章演習 8-2 で学んだ RGB ヒストグラム特徴量 は、カラー画像でこそ意味を持つ手法でした。本節では、カラー画像のベンチマーク CIFAR-10 を題材に、RGB ヒストグラムを使った画像分類を実装します。
9.4.1 CIFAR-10 データセット
CIFAR-10(Canadian Institute For Advanced Research, 10 classes)は、10 種類の物体・動物のカラー画像から構成される、機械学習の代表的なベンチマークデータセットです。
| 項目 | 内容 |
|---|---|
| 内容 | 10 種類の物体・動物のカラー画像 |
| クラス | airplane / automobile / bird / cat / deer / dog / frog / horse / ship / truck |
| 画像サイズ | 32×32 ピクセル(RGB 3 チャンネル) |
| 訓練データ | 50,000 枚(オリジナル) |
| テストデータ | 10,000 枚(オリジナル) |
| クラス数 | 10 |
MNIST と同じく、本講義では学習時間短縮のため 500〜2000 枚のサブセットを使用します。
import numpy as np
import matplotlib.pyplot as plt

# CIFAR-10 サブセットの読み込み
data = np.load('cifar_500_color.npz')
X = data['X']   # (500, 32, 32, 3)  500 枚の RGB 画像
y = data['y']   # (500,)  ラベル(0-9)

class_names = ['airplane', 'automobile', 'bird', 'cat', 'deer',
               'dog', 'frog', 'horse', 'ship', 'truck']

print(f"画像データの形状: {X.shape}")
print(f"画像の枚数: {len(X)}")
print(f"クラス数: {len(np.unique(y))}")
print(f"ラベル分布: {np.bincount(y)}")

# 各クラスから 1 枚ずつサンプル表示
fig, axes = plt.subplots(2, 5, figsize=(12, 5))
for i in range(10):
    idx = np.where(y == i)[0][0]
    ax = axes[i // 5, i % 5]
    ax.imshow(X[idx])
    ax.set_title(class_names[i])
    ax.axis('off')

plt.tight_layout()
plt.show()
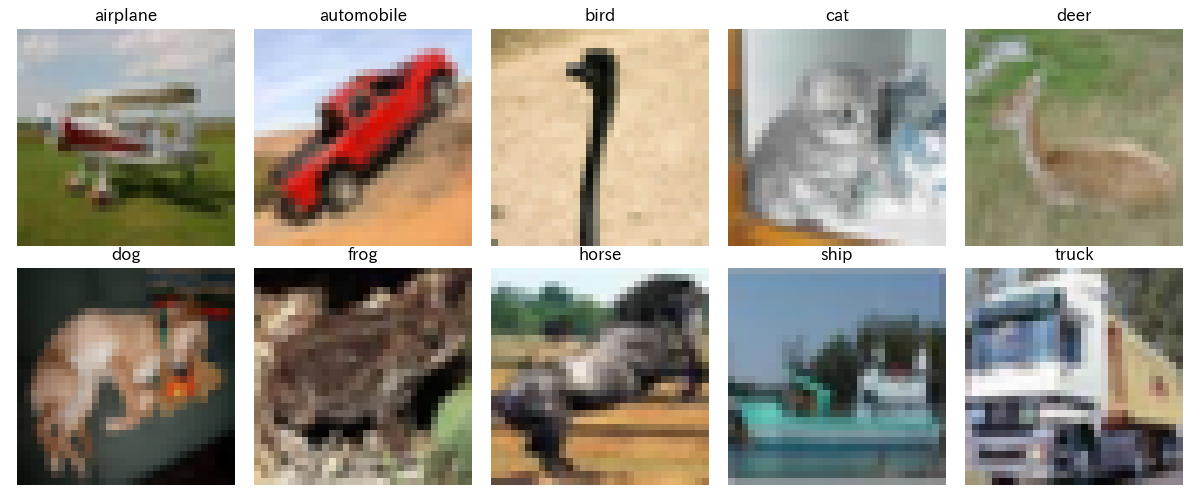
CIFAR-10 サブセット
- サイズ: 32×32 ピクセル × RGB 3 チャンネル
- 枚数: 500 枚(各クラス 50 枚ずつ)
- データセット:
CIFAR-10 全体(60,000 枚)を使う場合
keras 経由で CIFAR-10 全体を読み込めます(初回ダウンロード約 170 MB)。
from tensorflow.keras.datasets import cifar10

(X_train, y_train), (X_test, y_test) = cifar10.load_data()
y_train = y_train.flatten()  # (50000, 1) → (50000,) に揃える
y_test = y_test.flatten()

print(f"訓練データ: {X_train.shape}, ラベル: {y_train.shape}")
print(f"テストデータ: {X_test.shape}, ラベル: {y_test.shape}")
本講義のサブセットと同じ (N, 32, 32, 3) の uint8 配列が得られるので、以降のコードはそのまま動きます。tensorflow がインストールされていない場合は pip install tensorflow が必要です。
9.4.2 RGB ヒストグラム特徴量の抽出
第 8 章演習 8-2 で学んだように、numpy.histogram で各カラーチャンネルの画素値分布を計算できます。これを R・G・B 全チャンネルで行い、3 本のヒストグラムを連結したベクトルを 1 枚の画像の特徴量とします。各チャンネルを bins=32 のヒストグラムにすると、1 画像あたり 3 × 32 = 96 次元の特徴ベクトルが得られます。
import numpy as np

# 1 枚のカラー画像から R, G, B のヒストグラムを連結した特徴ベクトルを返す
def extract_rgb_histogram(image, bins=32):
    features = []
    for ch in range(3):
        hist, _ = np.histogram(image[:, :, ch], bins=bins, range=(0, 256))
        features.append(hist)
    return np.concatenate(features)

# 全画像から特徴量を抽出
X_hist = np.array([extract_rgb_histogram(img, bins=32) for img in X])

print(f"特徴量の形状: {X_hist.shape}")
print(f"各画像の特徴次元: {X_hist.shape[1]}")
9.4.3 モデルの学習と評価
抽出した RGB ヒストグラム特徴量を使って、9.2 / 9.3 と同じく決定木で 10 クラス分類を行います。
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix
import matplotlib.pyplot as plt
import seaborn as sns

# データ分割
X_train, X_test, y_train, y_test = train_test_split(
    X_hist, y, test_size=0.2, random_state=42, stratify=y
)

# 決定木で学習
model = DecisionTreeClassifier(random_state=42)
model.fit(X_train, y_train)
y_pred = model.predict(X_test)

# 精度評価
accuracy = accuracy_score(y_test, y_pred)
print(f"テスト精度: {accuracy:.4f} ({accuracy:.2%})")
print("\n分類レポート:")
print(classification_report(y_test, y_pred, target_names=class_names))

# 混同行列の可視化
cm = confusion_matrix(y_test, y_pred)
plt.figure(figsize=(10, 8))
sns.heatmap(cm, annot=True, fmt='d', cmap='Blues',
            xticklabels=class_names, yticklabels=class_names,
            cbar_kws={'label': '件数'})
plt.xlabel('予測ラベル')
plt.ylabel('正解ラベル')
plt.title(f'CIFAR-10 RGB ヒストグラム + 決定木(精度: {accuracy:.3f})')
plt.tight_layout()
plt.show()
9.4.4 結果の考察
RGB ヒストグラム特徴量と決定木の組み合わせで、CIFAR-10 サブセット(500 枚)に対する精度は約 19%。ランダム選択(10%)の倍程度ですが、MNIST + HOG で得られた精度には全く届きません。なぜ精度が伸びないのか、考えてみましょう。
9.5 CNN の紹介
9.5.1 CNN(畳み込みニューラルネットワーク)とは
これまで学んだ古典的な手法では、人間が特徴を設計する必要がありました(HOG、エッジ検出など)。一方、CNN(Convolutional Neural Network: 畳み込みニューラルネットワーク) は、データから自動的に特徴を学習するディープラーニングの手法です。
graph TB
    A[古典的手法] --> B[人間が特徴を設計<br/>HOG, SIFT, エッジなど]
    B --> C[機械学習で分類<br/>ロジスティック回帰, SVMなど]

    D[CNN ディープラーニング] --> E[データから自動で<br/>特徴を学習]
    E --> F[学習した特徴で<br/>分類]

    style A fill:#ccffcc,stroke:#66cc66,stroke-width:2px
    style B fill:#e6ffe6,stroke:#66cc66,stroke-width:1px
    style C fill:#ccffcc,stroke:#66cc66,stroke-width:2px

    style D fill:#ffffcc,stroke:#ffcc00,stroke-width:2px
    style E fill:#fffef0,stroke:#ffcc00,stroke-width:1px
    style F fill:#ffffcc,stroke:#ffcc00,stroke-width:2px
9.5.2 CNN の基本構造
CNN は主に以下の層から構成されます。
graph TB
    A[入力画像] --> B[畳み込み層<br/>Convolution]
    B --> C[プーリング層<br/>Pooling]
    C --> D[畳み込み層<br/>Convolution]
    D --> E[プーリング層<br/>Pooling]
    E --> F[全結合層<br/>Dense]
    F --> G[出力<br/>クラス予測]

    style A fill:#e6f3ff,stroke:#66b3ff,stroke-width:3px
    style B fill:#ccffcc,stroke:#66cc66,stroke-width:2px
    style C fill:#ffffcc,stroke:#ffcc00,stroke-width:2px
    style D fill:#ccffcc,stroke:#66cc66,stroke-width:2px
    style E fill:#ffffcc,stroke:#ffcc00,stroke-width:2px
    style F fill:#ffcccc,stroke:#ff6666,stroke-width:2px
style G fill:#e6ccff,stroke:#9966ff,stroke-width:3px主要な構成要素:
-
畳み込み層(Convolutional Layer)
- フィルタ(カーネル)を画像上でスライドさせて特徴を抽出
- 第 8 回で学んだ Sobel フィルタと同じ原理
- CNN では、フィルタの値をデータから自動的に学習
-
プーリング層(Pooling Layer)
- 特徴マップのサイズを削減
- 位置のずれに対する不変性を高める
- 最大プーリング(Max Pooling)が一般的
-
全結合層(Fully Connected Layer)
- 抽出された特徴から最終的なクラス予測を行う
9.5.3 古典的手法と CNN の比較
| 項目 | 古典的手法(HOG + 機械学習) | CNN(ディープラーニング) |
|---|---|---|
| 特徴設計 | 人間が設計 | データから自動学習 |
| 精度 | 中程度 | 非常に高い |
| 必要なデータ量 | 少量でも可 | 大量のデータが必要 |
| 計算コスト | 低い | 高い(GPU 推奨) |
| 解釈性 | 高い(どの特徴を使うか明確) | 低い(ブラックボックス) |
| 実装の難易度 | 比較的簡単 | やや複雑 |
CNN の性能
- MNIST(手書き数字): 99%以上の精度
- ImageNet(100万枚の画像、1000クラス): 90%以上の精度
- 画像認識コンペティションで人間の精度を超える
9.5.4 CNN の学習プロセス
CNN は以下のような流れで学習します。
graph TB
    A[訓練データ<br/>画像+ラベル] --> B[CNN モデル]
    B --> C[予測結果]
    C --> D[損失計算<br/>予測と正解の差]
    D --> E[誤差逆伝播]
    E --> F[フィルタの更新]
    F --> B

    style A fill:#e6f3ff,stroke:#66b3ff,stroke-width:2px
    style B fill:#ffffcc,stroke:#ffcc00,stroke-width:3px
    style C fill:#ccffcc,stroke:#66cc66,stroke-width:2px
    style D fill:#ffcccc,stroke:#ff6666,stroke-width:2px
    style E fill:#e6ccff,stroke:#9966ff,stroke-width:2px
style F fill:#ffe6cc,stroke:#ff9933,stroke-width:2px- 順伝播: 画像を入力し、フィルタを通して予測
- 損失計算: 予測と正解の差を計算
- 逆伝播: 損失を小さくするようにフィルタを更新
- これを繰り返してフィルタを最適化
CNN を学ぶには
CNN の詳細な実装を学ぶには、以下のフレームワークを使用します。
- TensorFlow / Keras: Python の代表的なディープラーニングフレームワーク
- PyTorch: 研究でよく使われるフレームワーク
興味がある方は、各フレームワークの公式チュートリアルを参照してください。
9.6 演習問題
演習 9-1: MNIST + 生の画素値 + ロジスティック回帰
演習 9-1(初級)
MNIST サブセット(500 サンプル)の生の画素値を、ロジスティック回帰で分類し、テスト精度を確認してください。
タスク
- MNIST サブセット(500 サンプル)を読み込む
- 訓練 80%・テスト 20% に分割(
random_state=42,stratify=y) LogisticRegression(max_iter=1000, random_state=42)で学習し、テスト精度を表示する
演習 9-2: MNIST + HOG 特徴量 + ロジスティック回帰
演習 9-2(初級)
MNIST サブセット(500 サンプル)から HOG 特徴量を抽出し、ロジスティック回帰で分類してテスト精度を確認してください。
タスク
- MNIST サブセット(500 サンプル)を読み込み、
(N, 28, 28)に reshape する - HOG 特徴量を抽出(
orientations=9, pixels_per_cell=(7, 7), cells_per_block=(2, 2)) - 訓練 80%・テスト 20% に分割(
random_state=42,stratify=y) LogisticRegression(max_iter=1000, random_state=42)で学習し、テスト精度を表示する
演習 9-3: CIFAR-10 + RGB ヒストグラム + 複数モデル比較
演習 9-3(中級)
CIFAR-10 サブセット(500 サンプル)から RGB ヒストグラム特徴量を抽出し、決定木・ロジスティック回帰・ランダムフォレストの 3 つのモデルで分類精度を比較してください。
タスク
- CIFAR-10 サブセット(500 サンプル)を読み込む
bins=32の RGB ヒストグラム特徴量を抽出する- 訓練 80%・テスト 20% に分割(
random_state=42,stratify=y) - 以下 3 モデルでテスト精度を計算する
DecisionTreeClassifier(random_state=42)LogisticRegression(max_iter=2000, random_state=42)RandomForestClassifier(n_estimators=100, random_state=42)
- 結果を一覧表示する
データセット: https://ml.kano.ac/lectures/data/cifar_500_color.npz
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score

# 1. CIFAR-10 サブセットを読み込み

# 2. RGB ヒストグラム特徴量を抽出(bins=32)

# 3. 訓練・テストに分割

# 4. 3 モデルでテスト精度を計算

# 5. 結果を一覧表示
9.7 課題 9
課題 9: CIFAR-10 のカラー画像分類
CIFAR-10 の画像を分類するモデルを 2 つ以上実装し、精度について比較・考察してください。
※ 加点要素
- 3 つ以上の改善を試す(特徴量 + モデルの両方を工夫)
- サブセットサイズ(500 → 1000 → 2000)を変えたときの精度の伸びを確認する
- 誤分類された画像を可視化し、どのようなクラスが混同されやすいかを分析する
提出物:
- Word ファイルで作成し、PDF 形式で出力して提出(学生番号_氏名_9.pdf)
- 問題文・ソースコード・結果・考察を PDF 内に含めること(参考:
機械学習_レポートサンプル.docx)
提出期限: 2026年6月28日(日)23:59
提出先: manaba
CIFAR-10 サブセット(データセット)
ヒント①:カラー画像での HOG 特徴量
OpenCV や skimage.color.rgb2gray でカラー画像をグレースケールに変換し、第 8 章で学んだ HOG 特徴量を抽出できます。
import numpy as np
from skimage.feature import hog
from skimage.color import rgb2gray
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score

data = np.load('cifar_500_color.npz')
X = data['X']
y = data['y']

# HOG 特徴量(グレースケールに変換してから抽出)
X_hog = np.array([
    hog(rgb2gray(img), orientations=9,
        pixels_per_cell=(4, 4), cells_per_block=(2, 2))
    for img in X
])
print(f"HOG 特徴量の次元: {X_hog.shape[1]}")

X_train, X_test, y_train, y_test = train_test_split(
    X_hog, y, test_size=0.2, random_state=42, stratify=y
)
model = LogisticRegression(max_iter=2000, random_state=42)
model.fit(X_train, y_train)
print(f"HOG + LogReg 精度: {accuracy_score(y_test, model.predict(X_test)):.4f}")
ヒント②:複数特徴量の組み合わせ
RGB ヒストグラムと HOG を numpy.concatenate で連結すれば、色情報と形状情報の両方を持つ特徴量になります。
# 1 画像から 「RGB ヒスト + HOG」を連結した特徴ベクトル
def extract_combined(image):
    hist_feats = []
    for ch in range(3):
        h, _ = np.histogram(image[:, :, ch], bins=32, range=(0, 256))
        hist_feats.append(h)
    hist_concat = np.concatenate(hist_feats)
    hog_feat = hog(rgb2gray(image), orientations=9,
                   pixels_per_cell=(4, 4), cells_per_block=(2, 2))
    return np.concatenate([hist_concat, hog_feat])
9.8 まとめ
本章では、生の画素値・HOG 特徴量・RGB ヒストグラム特徴量を用いた画像分類の実践と、CNN の概要について学びました。
第 9 回のまとめ
画像分類の基礎
- 画像を見てカテゴリを判定するタスク
- 特徴抽出 → 機械学習 → 予測
生の画素値を用いた画像分類(MNIST)
- 特徴抽出なしで決定木に与えると約 60% の精度
- 高次元の画像データには決定木が向かないことを示すベースライン
HOG 特徴量を用いた画像分類(MNIST)
- エッジの方向のヒストグラムで画像の重要な情報を 324 次元に圧縮
- 決定木では 56% にとどまる(特徴量が良くてもモデルが活かせなければ無意味)
RGB ヒストグラム特徴量を用いた画像分類(CIFAR-10)
- 第 8 章演習 8-2 の RGB ヒストグラムを画像分類の特徴量として活用
- 96 次元の低次元特徴量だが、決定木では約 19% にとどまる
- 空間情報を捨てるため複雑なカラー画像では限界が見える
古典的手法の利点と限界
- 利点: 少ないデータで動作、解釈性が高い、計算コストが低い
- 限界: 人間が特徴を設計する必要がある、色 + 形 + 空間配置を統合した特徴量は設計困難
CNN の紹介
- データから自動的に特徴を学習
- 古典的手法より高精度(MNIST で 99% 以上、CIFAR-10 でも 90%+ が可能)
- 大量のデータと計算資源が必要
- 現代の画像認識の中心的手法