6. 木構造・アンサンブル・SVM
第 6 回では、第 5 回で扱ったロジスティック回帰や k-近傍法に続く分類手法として、決定木 とそれを発展させた アンサンブル学習(ランダムフォレスト・勾配ブースティング)、さらに サポートベクターマシン(SVM) を学びます。
6.1 決定木
6.1.1 決定木とは
決定木(Decision Tree) は、データを「木構造」で分類・回帰するアルゴリズムです。if-then ルールの集まりとして表現され、人間が理解しやすいのが特徴です。
graph TB
    A[花弁の長さ ≤ 2.5cm?] -->|Yes| B[Setosa]
    A -->|No| C[花弁の幅 ≤ 1.7cm?]
    C -->|Yes| D[Versicolor]
    C -->|No| E[Virginica]

    style A fill:#e6ccff
    style B fill:#ccffcc
    style C fill:#ffffcc
    style D fill:#ffcccc
    style E fill:#e6f3ff
決定木の特徴
- 解釈性が高い:ルールが明確で説明しやすい
- 非線形:複雑な境界を表現できる
- 前処理不要:標準化やダミー変数化が不要
- 過学習しやすい:深くしすぎると訓練データに過度に適合
6.1.2 決定木の仕組み
決定木は、データを「分割」していくことで分類を行います。情報利得(Information Gain) や ジニ不純度(Gini Impurity) という指標を使って、最も効果的な分割方法を選びます。
ジニ不純度
ジニ不純度は、データの「混ざり具合」を表す指標です。
- 完全に1つのクラスだけ → ジニ不純度 = 0(純粋)
- クラスが均等に混ざっている → ジニ不純度が大きい(不純)
決定木は、ジニ不純度が小さくなるように分割を繰り返します。
6.1.3 決定木の実装
決定木を実装するには、sklearn.tree.DecisionTreeClassifier() クラスを使用します。学習した木の構造は sklearn.tree.plot_tree() で可視化できます。
import numpy as np
from sklearn.tree import DecisionTreeClassifier, plot_tree
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score, classification_report
import seaborn as sns
import matplotlib.pyplot as plt

# アヤメデータセットの読み込み
iris = sns.load_dataset('iris')

# 特徴量とラベルの分離
X = iris[['petal_length', 'petal_width']].values
y = iris['species'].values

# データ分割
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 決定木モデルの学習(最大深さ3)
model = DecisionTreeClassifier(max_depth=3, random_state=42)
model.fit(X_train, y_train)

# 予測と評価
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print(f"精度: {accuracy:.2%}")

# 決定木の可視化
plt.figure(figsize=(12, 8))
plot_tree(model, feature_names=['petal_length', 'petal_width'],
          class_names=['setosa', 'versicolor', 'virginica'], filled=True)
plt.show()
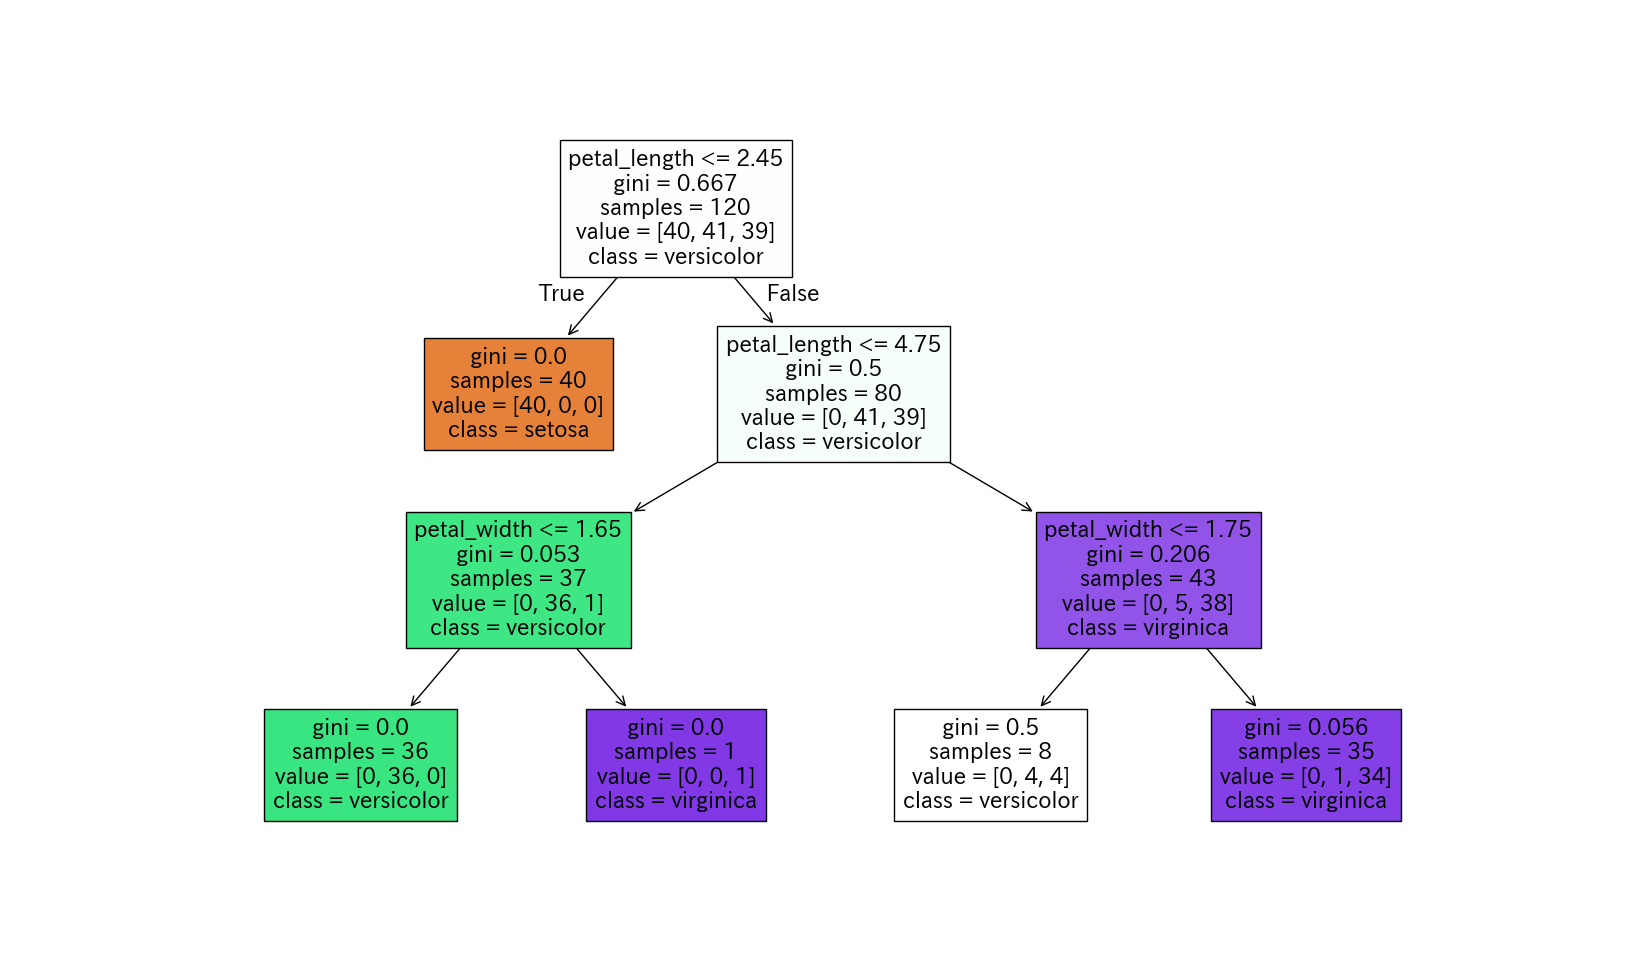
6.1.4 決定木のハイパーパラメータ
決定木の性能を調整するための主なハイパーパラメータは、以下になります。
| パラメータ | 説明 | 影響 |
|---|---|---|
max_depth |
木の最大深さ | 小さい→シンプル、大きい→複雑 |
min_samples_split |
分割に必要な最小サンプル数 | 大きい→シンプル |
min_samples_leaf |
葉ノードの最小サンプル数 | 大きい→シンプル |
決定木の過学習
max_depth=None(深さ制限なし)にすると、訓練データに完全に適合してしまい、テストデータでの性能が悪化します(過学習)。適切な深さは、交差検証などで決定します。
6.2 ランダムフォレスト
6.2.1 ランダムフォレストとは
ランダムフォレスト(Random Forest) は、複数の決定木を組み合わせたアンサンブル学習(集団学習) の一種です。
graph TB
    A[訓練データ] --> B1[決定木 1]
    A --> B2[決定木 2]
    A --> B3[決定木 3]
    A --> B4[...]
    A --> B5[決定木 N]

    B1 --> C[投票 / 平均]
    B2 --> C
    B3 --> C
    B4 --> C
    B5 --> C

    C --> D[最終予測]

    style A fill:#e6ccff
    style B1 fill:#ccffcc
    style B2 fill:#ccffcc
    style B3 fill:#ccffcc
    style B4 fill:#ccffcc
    style B5 fill:#ccffcc
    style C fill:#ffffcc
    style D fill:#ffcccc
ランダムフォレストの特徴
- 高精度:単一の決定木より高い精度
- 過学習に強い:複数の木の平均を取るため
- 特徴量の重要度:どの特徴量が重要かが分かる
- 並列化が可能:各木を独立に学習できる
6.2.2 ランダムフォレストの仕組み
ランダムフォレストは以下の手順で動作します。
- ブートストラップサンプリング:訓練データからランダムにサンプリング(重複あり)
- ランダムな特徴量選択:各分割でランダムに特徴量のサブセットを選択
- 複数の決定木を学習:それぞれ異なるデータ・特徴量で学習
- 投票で決定:全ての木の予測結果を多数決(分類)または平均(回帰)で決定
ランダム性を入れることによる恩恵
- 多様性:各決定木がさまざまなパターンを学習
- 汎化性能:特定のデータへの過度な適合を防ぐ
- ロバスト性:一部の木が間違えても、他の木が補える
6.2.3 ランダムフォレストの実装
ランダムフォレストを実装するには、sklearn.ensemble.RandomForestClassifier() クラスを使用します。
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score, classification_report
import seaborn as sns

# アヤメデータセットの読み込み
iris = sns.load_dataset('iris')

# 特徴量とラベルの分離
X = iris[['petal_length', 'petal_width']].values
y = iris['species'].values

# データ分割
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# ランダムフォレストモデルの学習
model = RandomForestClassifier(n_estimators=100, max_depth=3, random_state=42)
model.fit(X_train, y_train)

# 予測と評価
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print(f"精度: {accuracy:.2%}")
print("\n分類レポート:")
print(classification_report(y_test, y_pred))
6.2.4 ランダムフォレストのハイパーパラメータ
| パラメータ | 説明 | 推奨値 |
|---|---|---|
n_estimators |
木の数 | 100〜500 |
max_depth |
各木の最大深さ | 適宜調整 |
max_features |
分割時の特徴量数 | 'sqrt'(デフォルト) |
6.3 勾配ブースティング(発展)
発展トピック
本節は アンサンブルにはバギング系(並列)とブースティング系(直列)の二系統がある という大枠の理解を目的とした発展トピックです。実装の詳細より「ランダムフォレストとの違い」を押さえておきましょう。
6.3.1 勾配ブースティングとは
勾配ブースティング(Gradient Boosting) は、複数のモデルを順番に学習させるアンサンブル手法です。前のモデルの誤差を次のモデルが修正していくように学習します。
graph LR
    A[データ] --> B[モデル 1]
    B --> C[残差 1]
    C --> D[モデル 2]
    D --> E[残差 2]
    E --> F[モデル 3]
    F --> G[...]
    G --> H[最終予測]

    style A fill:#e6ccff
    style B fill:#ccffcc
    style D fill:#ccffcc
    style F fill:#ccffcc
    style H fill:#ffffcc
勾配ブースティングの特徴
- 高精度:多くのコンペで優勝実績あり
- 過学習しやすい:適切な正則化が必要
- 学習が遅い:順番に学習するため並列化が難しい
6.3.2 勾配ブースティングの実装
scikit-learn では sklearn.ensemble.GradientBoostingClassifier() クラスを使用します。
from sklearn.ensemble import GradientBoostingClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
import seaborn as sns

# データ準備
iris = sns.load_dataset('iris')
X = iris.drop('species', axis=1).values
y = iris['species'].values

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 勾配ブースティングモデルの学習
model = GradientBoostingClassifier(n_estimators=100, learning_rate=0.1, random_state=42)
model.fit(X_train, y_train)

# 予測と評価
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print(f"精度: {accuracy:.2%}")
6.3.3 XGBoost と LightGBM
実務では、勾配ブースティングの高速化・高性能化版である XGBoost や LightGBM がよく使われます。それぞれ xgboost.XGBClassifier() と lightgbm.LGBMClassifier() クラスを使用します。これらは scikit-learn とは独立した別パッケージなので、使用前にインストールが必要です。
# XGBoost の例
from xgboost import XGBClassifier

model = XGBClassifier(n_estimators=100, learning_rate=0.1, random_state=42)
model.fit(X_train, y_train)
# LightGBM の例
from lightgbm import LGBMClassifier

model = LGBMClassifier(n_estimators=100, learning_rate=0.1, random_state=42)
model.fit(X_train, y_train)
どれを使うべきか
- RandomForest:シンプルで扱いやすい、並列化可能
- GradientBoosting:基本的な勾配ブースティング
- XGBoost:高速・高精度、Kaggle で人気
- LightGBM:さらに高速、大規模データ向け
公式チュートリアル
本節の内容を実際に手を動かして深掘りしたい場合は、以下の公式ドキュメントを参照してください。
- scikit-learn の勾配ブースティング:User Guide / Gradient Tree Boosting
- XGBoost:Tutorials(Introduction to Boosted Trees が概念入門)
- LightGBM:Quick Start / Python Quick Start Guide
6.4 サポートベクターマシン
6.4.1 SVM とは
サポートベクターマシン(Support Vector Machine, SVM) は、クラスを分ける「境界」をマージン(margin)が最大になるように引く分類アルゴリズムです。ロジスティック回帰や k-近傍法と同じく「特徴量空間で境界を引く」手法ですが、SVM は「境界からデータ点までの距離(マージン)を最大化する」ことで、汎化性能の高い境界を得ることができます。上述の決定木やランダムフォレストとは異なる系統の手法となります。
SVM の特徴
- マージン最大化:境界とデータ点の距離(マージン)が最も大きくなる境界を選ぶため、汎化性能が高い
- カーネルトリック:非線形な境界も扱える(後述)
- 少データに強い:サンプルが少ない場面でも安定して動きやすい
- 標準化が必須:距離ベースの手法なので特徴量のスケールを揃える必要がある
- 大規模データに弱い:学習計算量がサンプル数に対して大きい(〜サンプル数の2〜3乗)
6.4.2 線形 SVM の考え方
マージン最大化
SVM のキモは「境界線の引き方」です。2 クラスを分ける直線は無数に引けますが、SVM は「両クラスから最も遠い(=マージンが最大の)境界」を選びます。
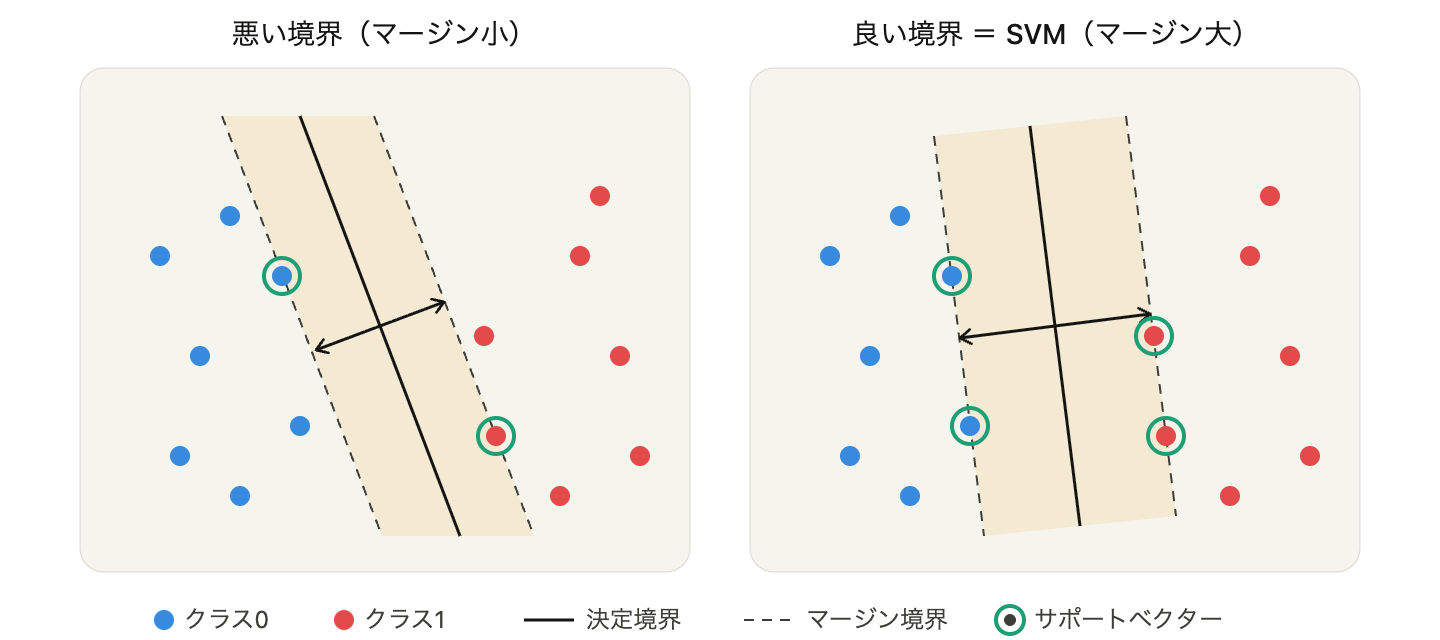
上図のように、同じデータでも引ける境界は無数にあります。SVM は境界から最も近いデータ点(サポートベクター、緑の丸)までの距離=マージンが最大になる境界を選びます。マージンが大きいほど、未知のデータに対しても正しく分類できる可能性が高くなります。
数式による定式化
2 クラス分類(ラベル \(y_i \in \{-1, +1\}\))で、決定境界を \(\mathbf{w} \cdot \mathbf{x} + b = 0\) とします。
線形 SVM の最適化問題
SVM は以下の最適化問題を解きます。
- \(\mathbf{w}\):境界面の法線ベクトル(境界の向きを決める)
- \(b\):バイアス項(境界の位置を決める)
- \(\|\mathbf{w}\|^2\) を最小化 = マージン \(\frac{2}{\|\mathbf{w}\|}\) を最大化
- 制約条件:全てのデータ点が正しく分類され、境界からの距離が 1 以上
直感的には「全データ点を正しく分類しつつ、マージンが最大になる \(\mathbf{w}\) と \(b\) を見つけよ」という問題です。
ソフトマージン SVM
現実のデータは完全に線形分離できないことが多いため、多少の誤分類を許容する ソフトマージン SVM を使います。
ソフトマージン SVM の最適化問題
各データ点に「マージン違反の度合い」\(\xi_i \geq 0\)(スラック変数)を導入します。
この目的関数は 2 つの項のバランスを取っています。
- \(\frac{1}{2} \|\mathbf{w}\|^2\):正則化項(マージンを広くする=モデルをシンプルに)
- \(C \sum \xi_i\):損失項(誤分類・マージン違反を減らす=データに合わせる)
\(C\) は両者のバランスを制御するパラメータです。
- \(C\) が大きい:損失項を重視 → 誤分類を許さない → マージンが狭く、過学習しやすい
- \(C\) が小さい:正則化項を重視 → 誤分類を許容 → マージンが広く、汎化しやすい
ロジスティック回帰の C と同じく、\(C\) が大きいほど正則化が弱い(=データに忠実、複雑な境界)という点に注意してください。
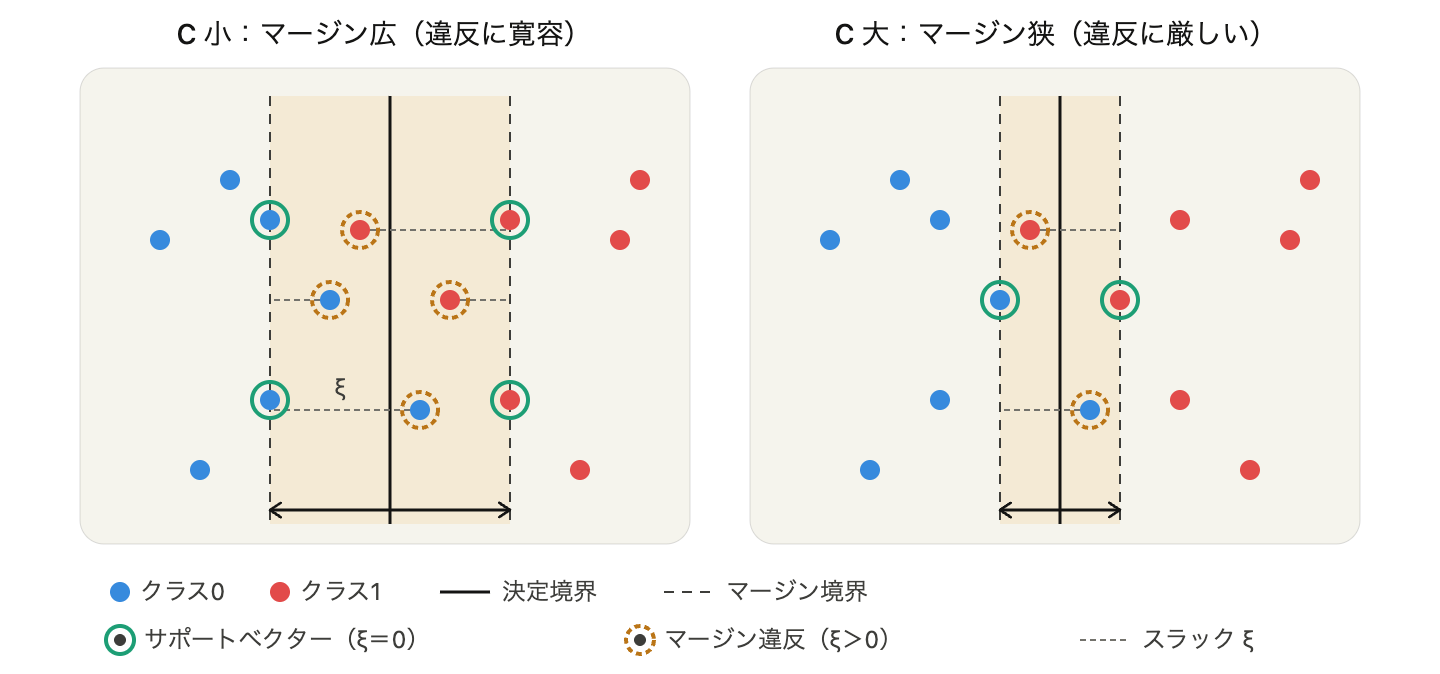
上図のように、\(C\) の大きさでマージンの広さと違反の許容度が変わります。
- \(C\) 小(左):マージンが広く、マージン内に入り込む点(\(\xi > 0\)、オレンジ破線の丸)を多く許容する。境界はシンプルだが、誤分類もやや増える
- \(C\) 大(右):マージンが狭く、違反を厳しく罰する。サポートベクター(緑の丸、\(\xi = 0\))のみがマージン境界上に並ぶ
6.4.3 RBF カーネルと非線形 SVM
なぜカーネルが必要か
直線では分けられないデータも存在します(下図の同心円データなど)。こうしたデータを分類するには、データを高次元空間に写像して、そこで線形に分離するというアイデアが考えられます。
graph LR
    A["元の空間(2次元)<br/>線形分離不可能"] -->|"写像 φ"| B["高次元空間<br/>線形分離可能"]
    B --> C["高次元で<br/>線形 SVM"]
    C --> D["元の空間では<br/>非線形な境界"]

    style A fill:#ffcccc
    style B fill:#ccffcc
    style C fill:#ffffcc
    style D fill:#e6f3ff
しかし、高次元空間での計算は非常にコストがかかります。ここで登場するのが カーネルトリック です。
カーネルトリック
線形 SVM の最適化問題は、実はデータ点同士の内積 \(\mathbf{x}_i \cdot \mathbf{x}_j\) だけで解けることが知られています。カーネルトリックとは、高次元空間での内積 \(\phi(\mathbf{x}_i) \cdot \phi(\mathbf{x}_j)\) を、元の空間で計算できるカーネル関数 \(K(\mathbf{x}_i, \mathbf{x}_j)\) で置き換えるテクニックです。
- \(\phi\):高次元空間への写像(実際には計算しない)
- \(K\):カーネル関数(元の空間の座標だけで計算できる)
つまり、データを実際に高次元に変換することなく、高次元で線形 SVM を解いたのと同じ結果が得られます。RBF カーネルの場合、写像先は無限次元ですが、カーネル関数の値は元の空間の距離だけで簡単に計算できます。
RBF カーネルの数式
最もよく使われる RBF(Radial Basis Function)カーネル は、2 つのデータ点 \(\mathbf{x}_i\) と \(\mathbf{x}_j\) の「類似度」を次のように定義します。
RBF カーネル関数
- \(\|\mathbf{x}_i - \mathbf{x}_j\|^2\):2 点間のユークリッド距離の 2 乗
- \(\gamma > 0\):カーネルの「幅」を制御するパラメータ
直感的な理解:
- 2 点が 近い → \(K\) が 1 に近い(類似している)
- 2 点が 遠い → \(K\) が 0 に近い(類似していない)
- \(\gamma\) が 大きい → 近い点だけに反応 → 境界が複雑(過学習しやすい)
- \(\gamma\) が 小さい → 遠い点にも反応 → 境界が滑らか(汎化しやすい)
scikit-learn のデフォルト gamma='scale' は \(\gamma = \frac{1}{n_\text{features} \cdot \text{Var}(X)}\) と自動設定されます。
カーネル関数の比較
| カーネル | 数式 | 境界の形 | 用途 |
|---|---|---|---|
linear |
\(K(\mathbf{x}_i, \mathbf{x}_j) = \mathbf{x}_i \cdot \mathbf{x}_j\) | 直線・超平面 | 特徴量数が多い・線形分離可能 |
rbf |
\(K(\mathbf{x}_i, \mathbf{x}_j) = \exp(- \gamma \|\mathbf{x}_i - \mathbf{x}_j\|^2)\) | 円・楕円・複雑な形状 | 一般的・最初に試す |
poly |
\(K(\mathbf{x}_i, \mathbf{x}_j) = (\gamma \, \mathbf{x}_i \cdot \mathbf{x}_j + r)^d\) | 多項式曲線 | 滑らかな非線形 |
RBF カーネルの決定境界
線形分離できない同心円状のデータに対して RBF カーネル SVM を適用することで、非線形な決定境界を得ることができます。
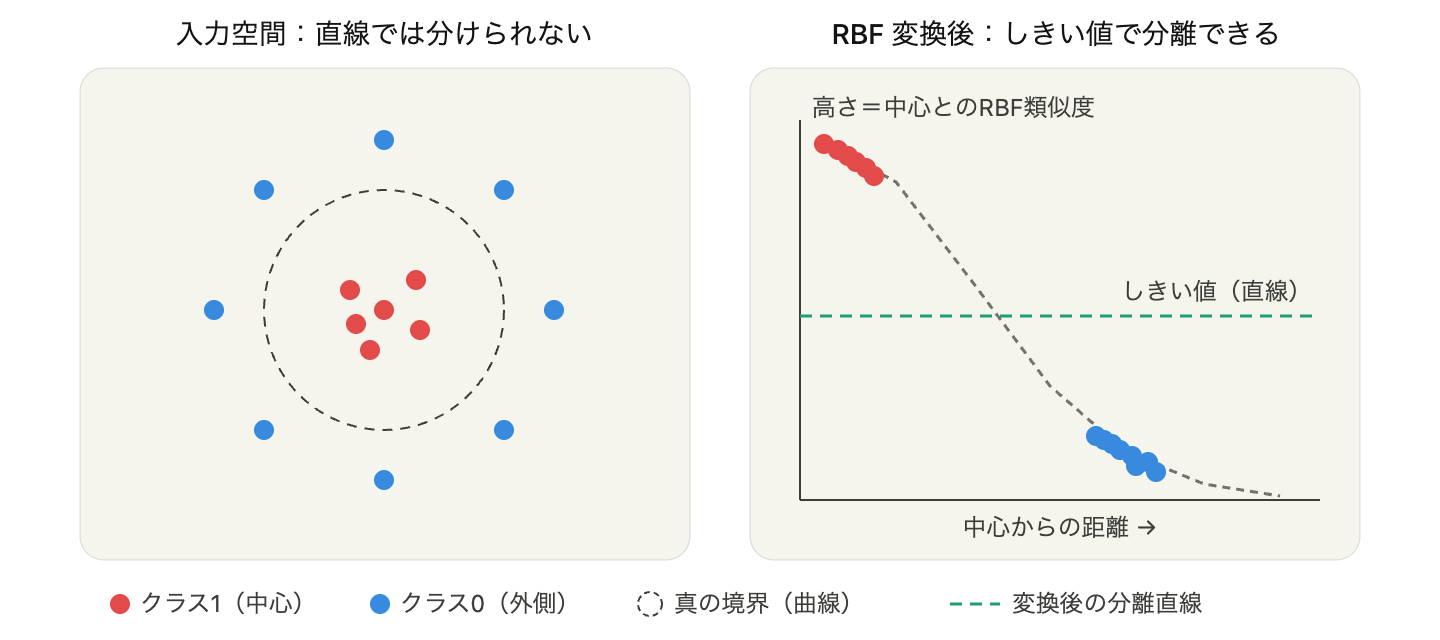
上図のように、線形カーネルでは分離できないデータも、RBF カーネルなら非線形な境界で(高次元空間では線形な境界で)正しく分類できます。
gamma の影響の可視化
RBF カーネルでは gamma の値が決定境界の複雑さを大きく左右します。
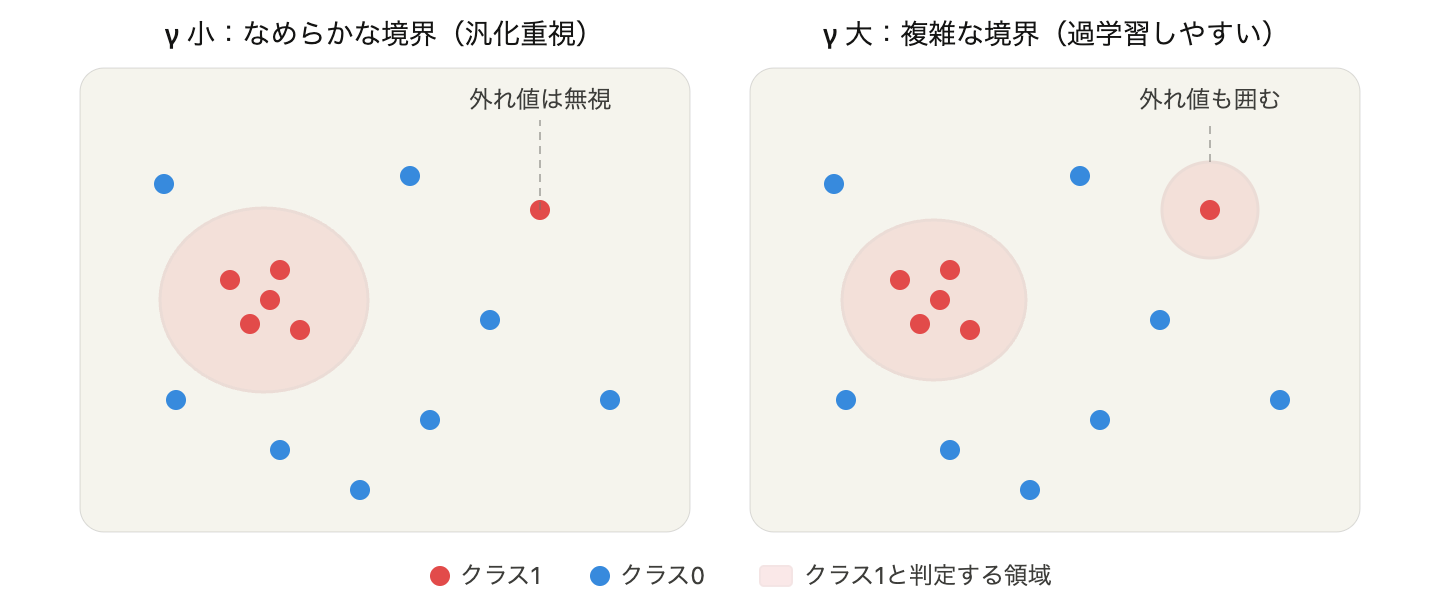
| gamma | 境界の特徴 | リスク |
|---|---|---|
| 小(0.1) | 滑らかで広い境界 | 未学習(境界が単純すぎる) |
| 中(1.0) | 適度な複雑さ | バランスが良い |
| 大(10.0) | 各データ点に密着した複雑な境界 | 過学習(訓練データに過度に適合) |
6.4.4 SVM の実装
SVM を実装するには、sklearn.svm.SVC() クラスを使用します。SVM は距離ベースの手法なので、sklearn.preprocessing.StandardScaler() による標準化をセットで行うのが基本です。
from sklearn.svm import SVC
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
import seaborn as sns

# アヤメデータセットの読み込み
iris = sns.load_dataset('iris')
X = iris[['petal_length', 'petal_width']].values
y = iris['species'].values

# データ分割
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 標準化(SVM では必須)
scaler = StandardScaler()
X_train_s = scaler.fit_transform(X_train)
X_test_s = scaler.transform(X_test)

# SVM モデルの学習(RBF カーネル)
model = SVC(kernel='rbf', C=1.0, gamma='scale', random_state=42)
model.fit(X_train_s, y_train)

# 予測と評価
y_pred = model.predict(X_test_s)
accuracy = accuracy_score(y_test, y_pred)
print(f"精度: {accuracy:.2%}")
6.4.5 SVM のハイパーパラメータ
| パラメータ | 説明 | 影響 |
|---|---|---|
kernel |
カーネルの種類 | 'rbf'(デフォルト)/ 'linear' / 'poly' |
C |
マージン違反のペナルティ | 小さい→シンプル、大きい→複雑 |
gamma |
RBF カーネルの幅 | 'scale'(自動)が無難 |
C と gamma の組み合わせ
C と gamma はどちらも境界の複雑さに影響するため、両方を同時に調整する必要があります。一般的には GridSearchCV や RandomizedSearchCV で組み合わせを探索します。
| gamma 小 | gamma 大 | |
|---|---|---|
| C 小 | 非常にシンプルな境界 | やや複雑だが正則化あり |
| C 大 | 滑らかだが厳密に分類 | 非常に複雑(過学習リスク大) |
SVM を使うべきケース
- 中規模データ(〜数万件)の分類
- 特徴量数 ≧ サンプル数(テキスト分類など)
- 非線形な決定境界が必要で、ランダムフォレスト等が過学習する場合
一方、サンプル数が数十万件を超える場合は、SVM の学習が遅くなるため、ランダムフォレストや LightGBM の方が現実的です。
6.5 異種モデルのアンサンブル(発展)
6.5.1 異種モデルを組み合わせる発想
ランダムフォレストや勾配ブースティングは「同じ種類のモデル(決定木)」を複数組み合わせるアンサンブルでした。これに対し、異なる系統のモデル(例:ロジスティック回帰・SVM・ランダムフォレスト)を組み合わせることもできます。各モデルが異なる「クセ」を持つため、組み合わせることで個々より安定した予測が得られる場合があります。
graph LR
    A[訓練データ] --> B[ロジスティック回帰]
    A --> C[SVM]
    A --> D[ランダムフォレスト]
    B --> E[投票 / 確率平均]
    C --> E
    D --> E
    E --> F[最終予測]

    style A fill:#e6ccff
    style B fill:#ccffcc
    style C fill:#ccffcc
    style D fill:#ccffcc
    style E fill:#ffffcc
    style F fill:#ffcccc
scikit-learn では以下の 2 つが代表的です。
- VotingClassifier:各モデルの予測を多数決(hard)または確率平均(soft)で集約
- StackingClassifier:各モデルの予測を入力として、別の「メタ学習器」がもう一度学習
6.5.2 VotingClassifier
sklearn.ensemble.VotingClassifier() クラスを使います。estimators に「(名前, モデル)」のタプルのリストを渡し、voting='hard'(多数決)または voting='soft'(確率平均)を指定します。標準化が必要なモデル(LR・SVM)は sklearn.pipeline.make_pipeline() で StandardScaler と一緒に包んでおくと、fit 時に自動で標準化されます。
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier, VotingClassifier
from sklearn.svm import SVC
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
import seaborn as sns

iris = sns.load_dataset('iris')
X = iris[['sepal_length', 'sepal_width']].values
y = iris['species'].values

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 標準化が必要なモデルは Pipeline で包む
lr = make_pipeline(StandardScaler(),
                   LogisticRegression(max_iter=1000, random_state=42))
svm = make_pipeline(StandardScaler(),
                    SVC(kernel='rbf', C=1.0, gamma='scale',
                        probability=True, random_state=42))
rf = RandomForestClassifier(n_estimators=100, max_depth=3, random_state=42)

# 異種モデルを多数決(soft voting)で結合
voting = VotingClassifier(
    estimators=[('lr', lr), ('svm', svm), ('rf', rf)],
    voting='soft'
)
voting.fit(X_train, y_train)
print(f"Voting (soft) 精度: {accuracy_score(y_test, voting.predict(X_test)):.2%}")
hard vs soft voting
- hard voting:各モデルが「最終的な予測クラス」を出して多数決
- soft voting:各モデルが「クラス確率」を出し、その平均値が最大のクラスを採用
soft voting の方が情報量が多く、一般に精度が高い傾向。ただし SVM では SVC(probability=True) の指定が必要です(確率を出すために内部で交差検証を行うため、学習がやや重くなります)。
6.5.3 StackingClassifier
sklearn.ensemble.StackingClassifier() はさらに発展した手法で、複数モデルの予測を「特徴量」として、上に積み上げた メタ学習器(通常はロジスティック回帰)が最終的な予測を行います。Kaggle などのコンペで上位入賞者がよく使う手法です。
graph LR
    A[訓練データ] --> B[ベース<br/>モデル群]
    B --> C[各モデルの予測<br/>= 新しい特徴量]
    C --> D[メタ学習器<br/>例: LR]
    D --> E[最終予測]

    style A fill:#e6ccff
    style B fill:#ccffcc
    style C fill:#ffffcc
    style D fill:#ffcccc
    style E fill:#e6f3ff
Voting と Stacking の使い分け
- Voting:シンプルで導入しやすい、計算も軽い
- Stacking:メタ学習器に「どのモデルをどれだけ信用するか」を学ばせる (性能上限は高いが、過学習リスクと計算コストも増える)
どちらも VotingClassifier(estimators=..., voting='soft') / StackingClassifier(estimators=..., final_estimator=LogisticRegression()) という形で、異種モデルを 1 つの fit / predict で扱える のが scikit-learn の便利な点です。
6.6 特徴量の重要度
6.6.1 特徴量の重要度とは
ランダムフォレストや勾配ブースティングでは、各特徴量がどれだけ予測に貢献しているかを定量的に評価できます。
6.6.2 特徴量の重要度の可視化
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.ensemble import RandomForestClassifier
import seaborn as sns

# データ準備
iris = sns.load_dataset('iris')
X = iris.drop('species', axis=1)
y = iris['species']

# ランダムフォレストの学習
model = RandomForestClassifier(n_estimators=100, random_state=42)
model.fit(X, y)

# 特徴量の重要度
importances = model.feature_importances_
feature_names = X.columns

# DataFrameに整理
importance_df = pd.DataFrame({
    '特徴量': feature_names,
    '重要度': importances
}).sort_values('重要度', ascending=False)

print("特徴量の重要度:")
print(importance_df)

# 可視化
plt.figure(figsize=(8, 5))
plt.barh(importance_df['特徴量'], importance_df['重要度'])
plt.xlabel('重要度')
plt.title('特徴量の重要度')
plt.gca().invert_yaxis()
plt.show()
特徴量の重要度の活用
- 特徴量選択:重要度の低い特徴量を削除してモデルを簡略化
- データ収集の優先順位:重要な特徴量を優先的に収集
- ビジネス理解:どの要因が重要かを理解
6.7 モデルの比較
6.7.1 各手法の特徴まとめ
5・6 章で扱った 6 つの分類手法を一覧で比較します。
| 手法 | 精度 | 解釈性 | 学習速度 | 過学習 | 標準化 |
|---|---|---|---|---|---|
| ロジスティック回帰(5 章) | 中 | 高 | 速い | しにくい | 推奨 |
| k-近傍法(5 章) | 中 | 中 | 学習は速い/予測は遅い | k に依存 | 必須 |
| 決定木 | 中 | 高 | 速い | しやすい | 不要 |
| ランダムフォレスト | 高 | 中 | 普通 | しにくい | 不要 |
| 勾配ブースティング | 高 | 低 | 遅い | しやすい | 不要 |
| SVM | 高 | 低 | 中規模以上で遅い | しにくい | 必須 |
標準化の要不要は系統で決まる
- 距離・内積を使う系(k-NN, SVM, ロジスティック回帰)→ 標準化を行う
- 木の分割を使う系(決定木, ランダムフォレスト, 勾配ブースティング)→ 標準化は不要
モデルの仕組みを思い出せば、標準化が必要かどうかは判断できます。
6.7.2 使い分けの指針
graph TB
    A[モデル選択] --> B{解釈性が重要?}
    B -->|Yes| C[決定木]
    B -->|No| D{データサイズ?}
    D -->|小〜中| E{特徴量の重要度<br/>が欲しい?}
    D -->|大| F[LightGBM / XGBoost]
    E -->|Yes| G[ランダムフォレスト]
    E -->|No| H[SVM / ランダムフォレスト]

    style A fill:#e6ccff
    style C fill:#ccffcc
    style F fill:#ffcccc
    style G fill:#ffffcc
    style H fill:#ffffcc
より細かい使い分けの指針
scikit-learn 公式の Choosing the right estimator は、データ量を起点に「Linear SVC → KNeighbors → SVC → アンサンブル」のように試す順序を示しており、回帰・クラスタリング・次元削減もカバーしています(XGBoost / LightGBM は対象外)。本章の指針と合わせて参考にしてください。
6.8 演習問題
演習 6-1: penguins データセットで決定木
演習 6-1(初級)
penguins データセットを使って、bill_length_mm・bill_depth_mm・body_mass_g の 3 つの数値特徴量からペンギンの種類(species:Adelie / Chinstrap / Gentoo)を分類する決定木を実装してください。
タスク
- penguins データセットを読み込み、
dropna()で欠損値のある行を削除する - 特徴量
X = penguins[['bill_length_mm', 'bill_depth_mm', 'body_mass_g']]、ラベルy = penguins['species']を準備する - データを「訓練 80%、テスト 20%」(
random_state=42)に分割する - 決定木モデル
DecisionTreeClassifier(max_depth=3, random_state=42)を学習する - テストデータで予測し、正解率(accuracy)と
classification_reportを表示する plot_treeで学習した木構造を可視化する
import seaborn as sns
import matplotlib.pyplot as plt
from sklearn.tree import DecisionTreeClassifier, plot_tree
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score, classification_report

# 1. データの読み込みと欠損値の削除

# 2. 特徴量 X とラベル y の設定

# 3. 訓練・テストに分割(8:2, random_state=42)

# 4. 決定木モデル(max_depth=3)の学習

# 5. テストデータで予測し、正解率と classification_report を表示

# 6. plot_tree で木構造を可視化
演習 6-2: penguins データセットでランダムフォレスト
演習 6-2(中級)
penguins データセットを使って、bill_length_mm・bill_depth_mm・body_mass_g の 3 つの数値特徴量からペンギンの種類(species:Adelie / Chinstrap / Gentoo)を分類するランダムフォレストを実装してください。また、特徴量の重要度を確認し、精度について考察してください。
タスク
- penguins データセットを読み込み、
dropna()で欠損値を削除する - 特徴量
bill_length_mm・bill_depth_mm・body_mass_gの 3 列とラベルspeciesを準備する - データを「訓練 80%、テスト 20%」(
random_state=42)に分割する - ランダムフォレスト
RandomForestClassifier(n_estimators=100, max_depth=3, random_state=42)を学習し、テストデータの正解率を表示する feature_importances_を取り出し、特徴量名と一緒にpandas.DataFrame()にまとめて重要度の降順で表示する- 棒グラフで重要度を可視化する
- 決定木と比べて何が変わったか、コメントで考察する
import seaborn as sns
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

# 1. データの読み込みと欠損値の削除

# 2. 特徴量 X とラベル y の設定

# 3. 訓練・テストに分割(8:2, random_state=42)

# 4. ランダムフォレストの学習と正解率の表示

# 5. 特徴量の重要度を DataFrame に整理して表示

# 6. 棒グラフで可視化

# 7. 考察(決定木と比べて何が変わったか)をコメントで記述
演習 6-3: penguins データセットで SVM
演習 6-3(中級)
penguins データセットを使って、bill_length_mm・bill_depth_mm・body_mass_g の 3 つの数値特徴量からペンギンの種類(species:Adelie / Chinstrap / Gentoo)を分類する SVM(RBF カーネル)を実装してください。また、マージン違反のペナルティ C を複数の値で試し、精度の変化を確認してください。
タスク
- penguins データセットを読み込み、
dropna()で欠損値を削除する - 特徴量
bill_length_mm・bill_depth_mm・body_mass_gの 3 列とラベルspeciesを準備し、訓練 80%・テスト 20% に分割する(random_state=42) StandardScalerで特徴量を標準化するSVC(kernel='rbf', gamma='scale', random_state=42)のCを複数値で試し、テスト精度を比較するCと性能の関係性について、コメントで考察する
import seaborn as sns
from sklearn.svm import SVC
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

# 1. データの読み込みと欠損値の削除

# 2. 特徴量 X とラベル y の設定 + 訓練・テストに分割(8:2, random_state=42)

# 3. StandardScaler で標準化

# 4. 複数の C で SVM(RBF)を学習し、精度を比較

# 5. 考察をコメントで記述
6.9 まとめ
本章では、木構造とアンサンブル学習、SVM について学び、第 5 回のロジスティック回帰・k-近傍法と合わせて 6 つの分類モデルを扱いました。
第 6 回のまとめ
決定木
- if-then ルールで分類・回帰
- 解釈性が高いが過学習しやすい
max_depthで複雑さを制御
ランダムフォレスト
- 複数の決定木を組み合わせたアンサンブル学習
- 高精度で過学習に強い
- 特徴量の重要度が分かる
勾配ブースティング
- モデルを順番に学習させる手法
- XGBoost、LightGBM が実務で人気
- 高精度だが過学習に注意
サポートベクターマシン(SVM)
- マージン最大化で境界を引く幾何的な分類手法
- カーネルトリックで非線形な境界も扱える
- 標準化が必須、大規模データには向かない
異種モデルのアンサンブル
VotingClassifier:複数モデルの予測を多数決/確率平均で統合StackingClassifier:モデルの予測を入力としてメタ学習器が再学習- 単体最良のモデルを事前に知らなくても安定した精度に到達できる
特徴量の重要度
- どの特徴量が予測に貢献しているかを定量化
- 特徴量選択やビジネス理解に活用
6.10 レポート課題の補足
breast_cancer データセットについて
breast_cancer データセットは、乳がん(Wisconsin Diagnostic Breast Cancer)の検査画像から算出された数値特徴量と、悪性 / 良性のラベルからなる 2 値分類用データセットです。前処理(欠損補完・カテゴリ変数化)は不要で、以下のようにして読み込ませることができます。
from sklearn.datasets import load_breast_cancer
import pandas as pd

data = load_breast_cancer()
X = pd.DataFrame(data.data, columns=data.feature_names)
y = pd.Series(data.target, name='target')  # 0=悪性, 1=良性
print(X.shape, y.value_counts().to_dict())
- サンプル数:569(悪性 212、良性 357)
- 特徴量数:30 = 10 の基本計測値 × 3 統計量(平均
mean ...・標準誤差... error・最悪値worst ...) - 公式リンク:
10 個の基本計測値(細胞核の画像から算出)
| 特徴量 | 説明 |
|---|---|
radius |
中心から外周までの距離 |
texture |
グレースケール値の標準偏差 |
perimeter |
周囲長 |
area |
面積 |
smoothness |
半径の局所的な変動 |
compactness |
\(perimeter^2 / area - 1\) |
concavity |
輪郭の凹みの大きさ |
concave points |
凹み点の数 |
symmetry |
対称性 |
fractal dimension |
フラクタル次元(coastline approximation - 1) |
上の 10 項目を、それぞれ「平均」「標準誤差」「最悪値(最大の 3 値の平均)」で計算した計 30 列が特徴量です(例:mean radius, radius error, worst radius)。
ターゲット
target = 0:悪性(malignant)target = 1:良性(benign)